API Text to Speech: Cara Membuat Suara Panggilan Antrean Otomatis (curl, Node.js, Python)
Oleh Tim APIPedia, Tim Engineering APIPedia · Terbit · 10 menit baca
API Text to Speech APIPedia mengubah teks jadi MP3 lewat POST /v1/tts. Tutorial suara panggilan antrean dengan curl, Node.js, dan Python.
API Text to Speech APIPedia mengubah teks menjadi berkas MP3 lewat satu request POST /v1/tts, dengan suara bawaan id-ID-GadisNeural untuk bahasa Indonesia. Kirim kalimat seperti "Nomor antrean A dua belas, silakan menuju loket tiga", dan API mengembalikan audio yang siap diputar di pengeras suara.
Tutorial ini memakai kasus yang sering dijumpai di klinik, apotek, bengkel, dan kantor layanan: suara panggilan antrean otomatis. Anda akan melihat contoh curl, Node.js, dan Python, respons nyata dari uji kami pada 17 November 2026, cara menyimpan audio agar hemat kuota, serta batas yang perlu Anda tahu sebelum memasangnya.
Ringkasan cepat: apa yang perlu Anda tahu?
Produk Text to Speech punya tiga endpoint: satu untuk membuat audio, satu untuk daftar suara, dan satu untuk status server. Tabel berikut merangkum intinya.
| Item | Detail |
|---|---|
| Buat audio | POST https://api.apipedia.id/v1/tts |
| Daftar suara | GET https://api.apipedia.id/v1/tts/voices (filter locale, gender, q) |
| Status server | GET https://api.apipedia.id/v1/tts/servers |
| Body wajib | text, maksimal 5.000 karakter |
| Body opsional | voice, rate (-50 sampai 100), pitch (-50 sampai 50), volume (-50 sampai 50), bitrate (48 atau 96), server (1 atau 2), output, subtitles |
| Bentuk hasil | Berkas audio/mpeg (bawaan), atau JSON berisi base64 lewat output: "base64" |
| Suara Indonesia | id-ID-GadisNeural (perempuan, bawaan) dan id-ID-ArdiNeural (laki-laki) |
| Jumlah suara | 318 suara pada uji 17 November 2026 |
| Autentikasi | Header Authorization: Bearer apk_xxx |
| Tier | Free pada katalog, versi 1.0.0 |
Masalah apa yang diselesaikan API Text to Speech?
API ini menghilangkan pekerjaan merekam suara satu per satu untuk setiap kalimat yang berubah-ubah. Panggilan antrean adalah contoh paling jelas: nomor dan loket selalu berganti, sehingga rekaman tetap tidak cukup dan petugas akhirnya memanggil dengan suara sendiri.
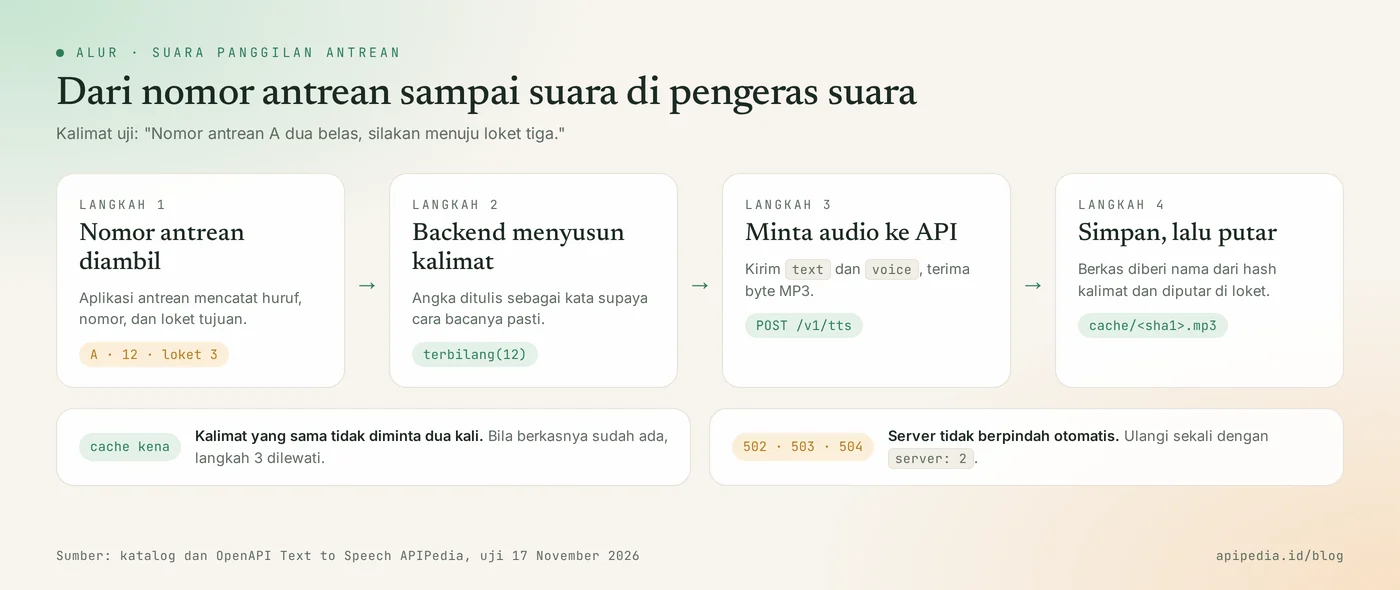
Dengan satu endpoint di backend, aplikasi antrean cukup menyusun kalimat dari nomor dan loket, lalu meminta audionya. Pola yang sama berlaku untuk kebutuhan lain:
- Pengumuman berulang. Jam tutup, panggilan pengambilan obat, atau pemberitahuan di ruang tunggu.
- Versi audio konten. Artikel, materi belajar, atau deskripsi produk yang ingin bisa didengarkan.
- Narasi video pendek. Audio plus subtitle SRT dari teks yang sama.
Apa yang perlu disiapkan sebelum mulai?
Anda hanya butuh satu kunci API APIPedia. Daftar atau masuk di console.apipedia.id, buka menu Token API, lalu buat kunci baru. Kunci berawalan apk_ dan dikirim lewat header Authorization: Bearer apk_xxx.
Simpan kunci di variabel lingkungan server, misalnya APIPEDIA_KEY, dan panggil API dari backend, bukan dari browser atau aplikasi tablet di loket. Perangkat di loket cukup menerima berkas MP3 dari server Anda.
Langkah 1: bagaimana membuat audio pertama dengan curl?
Kirim text dan voice ke POST /v1/tts, lalu simpan jawabannya sebagai berkas MP3 dengan opsi -o. Secara bawaan, jawaban berupa audio mentah bertipe audio/mpeg, bukan JSON.
curl -s -X POST https://api.apipedia.id/v1/tts \
  -H "Authorization: Bearer apk_xxx" \
  -H "Content-Type: application/json" \
  -d '{
    "text": "Nomor antrean A dua belas, silakan menuju loket tiga.",
    "voice": "id-ID-GadisNeural"
  }' \
  -o antrean-a12.mp3
Berkas antrean-a12.mp3 bisa langsung diputar. Menurut dokumentasi OpenAPI produk ini, respons audio membawa header X-TTS-Voice dan X-TTS-Server yang menunjukkan suara dan server yang dipakai.
Bagaimana memilih suara?
Daftar suara diambil dari GET /v1/tts/voices dengan filter locale, gender, atau q. Pada uji kami, locale=id mengembalikan dua suara: id-ID-GadisNeural dan id-ID-ArdiNeural.
curl -s "https://api.apipedia.id/v1/tts/voices?locale=id" \
  -H "Authorization: Bearer apk_xxx"
Respons yang sama memuat total (318 suara di semua bahasa), defaultVoice, dan objek limits berisi batas rate, pitch, volume, dan bitrate.
Langkah 2: bagaimana mendapat JSON, waktu per kata, dan subtitle?
Tambahkan "output": "base64" agar jawaban berupa JSON, dan "subtitles": true agar waktu tiap kata serta teks SRT ikut dikirim. Opsi subtitles hanya berlaku pada keluaran base64.
curl -s -X POST https://api.apipedia.id/v1/tts \
  -H "Authorization: Bearer apk_xxx" \
  -H "Content-Type: application/json" \
  -d '{
    "text": "Nomor antrean A dua belas, silakan menuju loket tiga.",
    "voice": "id-ID-GadisNeural",
    "output": "base64",
    "subtitles": true
  }'
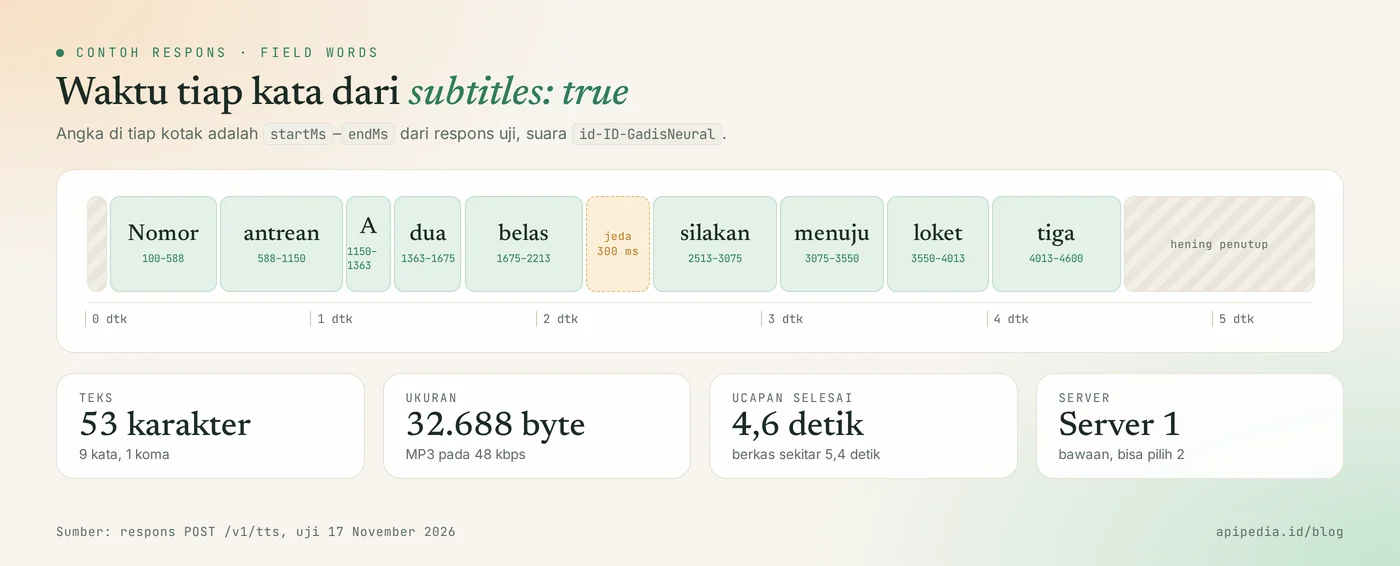
Respons nyata dari uji kami, dengan isi base64 dipersingkat:
{
  "is_success": true,
  "message": "Audio created.",
  "data": {
    "server": 1,
    "voice": "id-ID-GadisNeural",
    "format": "mp3",
    "contentType": "audio/mpeg",
    "bitrate": 48,
    "size": 32688,
    "characters": 53,
    "base64": "SUQzBAAAAAAA...",
    "words": [
      { "text": "Nomor", "startMs": 100, "endMs": 588 },
      { "text": "antrean", "startMs": 588, "endMs": 1150 },
      { "text": "A", "startMs": 1150, "endMs": 1363 },
      { "text": "dua", "startMs": 1363, "endMs": 1675 },
      { "text": "belas", "startMs": 1675, "endMs": 2213 },
      { "text": "silakan", "startMs": 2513, "endMs": 3075 },
      { "text": "menuju", "startMs": 3075, "endMs": 3550 },
      { "text": "loket", "startMs": 3550, "endMs": 4013 },
      { "text": "tiga", "startMs": 4013, "endMs": 4600 }
    ],
    "srt": "1\n00:00:00,100 --> 00:00:04,600\nNomor antrean A dua belas silakan menuju loket tiga\n"
  }
}| Field | Arti |
|---|---|
server | Server yang mengerjakan permintaan, 1 atau 2. |
size | Ukuran audio dalam byte. Kalimat 53 karakter menghasilkan 32.688 byte pada 48 kbps. |
characters | Jumlah karakter teks yang dibacakan. |
base64 | Isi berkas MP3 dalam base64. Decode lalu simpan sebagai .mp3. |
words | Waktu mulai dan selesai tiap kata dalam milidetik. |
srt | Subtitle siap pakai dalam format SRT. |
Dari data words terlihat kata terakhir selesai pada 4,6 detik dan ada jeda 300 milidetik di posisi koma. Berkas MP3-nya sendiri berdurasi sekitar 5,4 detik karena ada hening penutup. Angka ini berguna untuk memberi jeda antarpanggilan atau menyorot nomor di layar tepat saat diucapkan.
Langkah 3: bagaimana membuat suara panggilan antrean di Node.js?
Susun kalimat dari huruf, nomor, dan loket, minta audionya sekali, lalu simpan berkasnya dengan nama dari hash kalimat. Kalimat yang sama pada hari berikutnya dibaca dari disk tanpa memanggil API lagi. Contoh berikut berjalan di Node.js 18 ke atas tanpa dependensi tambahan.
// antrean.mjs - Node.js 18+, tanpa dependensi tambahan
import { createHash } from "node:crypto";
import { existsSync } from "node:fs";
import { mkdir, writeFile } from "node:fs/promises";

const URL_TTS = "https://api.apipedia.id/v1/tts";
const KEY = process.env.APIPEDIA_KEY; // apk_xxx
const DASAR = ["nol", "satu", "dua", "tiga", "empat", "lima", "enam",
  "tujuh", "delapan", "sembilan", "sepuluh", "sebelas"];

// Angka 0-999 menjadi kata, supaya cara bacanya bisa Anda kendalikan.
export function terbilang(n) {
  if (n < 12) return DASAR[n];
  if (n < 20) return `${DASAR[n - 10]} belas`;
  if (n < 100) return `${DASAR[Math.floor(n / 10)]} puluh${n % 10 ? ` ${DASAR[n % 10]}` : ""}`;
  if (n < 200) return `seratus${n % 100 ? ` ${terbilang(n % 100)}` : ""}`;
  if (n < 1000) return `${DASAR[Math.floor(n / 100)]} ratus${n % 100 ? ` ${terbilang(n % 100)}` : ""}`;
  throw new RangeError("Hanya mendukung 0 sampai 999");
}

export function kalimatPanggilan(huruf, nomor, loket) {
  return `Nomor antrean ${huruf} ${terbilang(nomor)}, silakan menuju loket ${terbilang(loket)}.`;
}

async function minta(text, server) {
  return fetch(URL_TTS, {
    method: "POST",
    headers: { Authorization: `Bearer ${KEY}`, "Content-Type": "application/json" },
    body: JSON.stringify({ text, voice: "id-ID-GadisNeural", rate: -5, server }),
  });
}

export async function suaraPanggilan(huruf, nomor, loket) {
  const text = kalimatPanggilan(huruf, nomor, loket);
  const berkas = `cache/${createHash("sha1").update(text).digest("hex")}.mp3`;
  if (existsSync(berkas)) return berkas; // kalimat sama, tidak perlu memanggil API lagi

  let res = await minta(text, 1);
  if ([502, 503, 504].includes(res.status)) res = await minta(text, 2); // pindah server manual
  if (!res.ok) {
    const body = await res.json().catch(() => ({}));
    throw new Error(`HTTP ${res.status}: ${body.message ?? "gagal membuat audio"}`);
  }
  await mkdir("cache", { recursive: true });
  await writeFile(berkas, Buffer.from(await res.arrayBuffer()));
  return berkas;
}

if (process.argv[1]?.endsWith("antrean.mjs")) {
  console.log(kalimatPanggilan("A", 12, 3));
  if (KEY) console.log(await suaraPanggilan("A", 12, 3));
}
Tiga keputusan di kode ini layak dicatat:
- Angka diubah menjadi kata. Fungsi
terbilangmenulis 12 sebagai "dua belas", sehingga cara bacanya Anda yang menentukan. Kalimat uji kami memakai bentuk kata ini. - Kecepatan diturunkan sedikit.
rate: -5membuat ucapan 5 persen lebih lambat, yang lebih nyaman di ruang tunggu yang ramai. - Pindah server dilakukan sendiri. Server tidak pernah berganti otomatis. Bila Server 1 menjawab 502, 503, atau 504, kode mengulang sekali ke Server 2.
Langkah 4: bagaimana contohnya di Python?
Di Python, minta keluaran base64 dengan requests, decode menjadi byte MP3, lalu pakai words untuk mengetahui kapan ucapan selesai. Contoh ini memakai suara laki-laki id-ID-ArdiNeural.
import base64
import os

import requests  # pip install requests

URL_TTS = "https://api.apipedia.id/v1/tts"
HEADERS = {"Authorization": f"Bearer {os.environ.get('APIPEDIA_KEY', '')}"}  # apk_xxx


def buat_audio(teks, voice="id-ID-ArdiNeural"):
    """Mengembalikan (bytes MP3, daftar waktu per kata)."""
    for server in (1, 2):  # server tidak pernah berpindah otomatis
        res = requests.post(
            URL_TTS,
            headers=HEADERS,
            json={
                "text": teks,
                "voice": voice,
                "server": server,
                "output": "base64",
                "subtitles": True,
            },
            timeout=60,
        )
        if res.status_code in (502, 503, 504) and server == 1:
            continue
        body = res.json()
        if not body.get("is_success"):
            raise RuntimeError(f"HTTP {res.status_code}: {body.get('message')}")
        data = body["data"]
        return base64.b64decode(data["base64"]), data.get("words", [])
    raise RuntimeError("Kedua server gagal")


if __name__ == "__main__":
    mp3, kata = buat_audio("Nomor antrean B tujuh, silakan menuju loket satu.")
    with open("antrean-b7.mp3", "wb") as f:
        f.write(mp3)
    durasi = kata[-1]["endMs"] / 1000 if kata else 0
    print(f"{len(mp3)} byte, sekitar {durasi:.1f} detik")
Apa batas Text to Speech yang perlu Anda tahu?
Batas utamanya adalah 5.000 karakter per request dan dua pilihan bitrate, 48 atau 96 kbps. Hal lain yang perlu diperhitungkan:
- Latensi bukan nol. Katalog mencatat rata-rata sekitar 1,8 detik per permintaan. Untuk antrean, buat audio saat nomor diambil, bukan saat tombol panggil ditekan.
- Respons tidak di-cache gateway. Dokumentasi menyebut header
Cache-Control: no-store, jadi penyimpanan audio adalah tugas aplikasi Anda. - Dua server, suara yang sama. Server 1 dan Server 2 menghasilkan suara yang sama. Cek ketersediaannya lewat
GET /v1/tts/servers. - Teks panjang dipecah per kalimat. Menurut katalog, audio tiap kalimat disambung kembali menjadi satu berkas.
- Pelafalan perlu diuji. Singkatan, nama orang, dan istilah asing bisa dibaca berbeda dari harapan. Dengarkan hasilnya sebelum dipakai di depan pelanggan.
Kesalahan umum apa yang perlu dihindari?
Kesalahan paling sering adalah memanggil API setiap kali tombol panggil ditekan, padahal kalimat panggilan berulang setiap hari. Simpan berkasnya seperti di Langkah 3. Periksa juga hal-hal berikut.
- Mengirim
subtitlestanpaoutput: "base64". Kombinasi ini ditolak dengan status 400. - Mem-parsing audio sebagai JSON. Keluaran bawaan adalah byte MP3. Pakai
arrayBuffer()ataures.content, bukanjson(). - Salah ketik nama suara. Nama suara harus persis, misalnya
id-ID-GadisNeural. Ambil dari/v1/tts/voices, jangan diketik dari ingatan. - Nilai di luar rentang.
rate150 ataubitrate128 ditolak dengan 400. - Menulis angka mentah untuk nomor penting. Tulis sebagai kata agar pelafalannya pasti.
- Memanggil dari browser. Kunci
apk_xxxakan terbaca siapa pun. Panggil dari backend.
Kode status yang perlu ditangani
| Status | Arti | Tindakan |
|---|---|---|
| 200 | Audio berhasil dibuat | Simpan atau putar berkasnya |
| 400 | Masukan tidak valid: teks kosong atau terlalu panjang, suara tidak dikenal, nilai di luar rentang | Baca message dan perbaiki body |
| 401 | Token tidak ada, tidak dikenal, atau kedaluwarsa | Periksa header Authorization |
| 502 | Server yang dipilih gagal membuat audio | Ulangi dengan server lain |
| 503 | Server yang dipilih sibuk atau tidak tersedia, disertai Retry-After: 60 | Pindah server atau tunggu |
| 504 | Permintaan melewati batas waktu | Perpendek teks atau ulangi |
Pertanyaan yang sering diajukan
Apakah API Text to Speech APIPedia gratis?
Produk Text to Speech tercatat di tier Free pada katalog APIPedia. Setiap panggilan tetap dihitung ke kuota request akun Anda.
Suara bahasa Indonesia apa saja yang tersedia?
Ada dua: id-ID-GadisNeural (perempuan, bawaan) dan id-ID-ArdiNeural (laki-laki). Katalog juga menyebut suara bahasa Jawa dan Sunda, yang bisa dicari lewat /v1/tts/voices?locale=jv atau locale=su.
Berapa panjang teks maksimal?
Maksimal 5.000 karakter per request. Teks panjang dipecah per kalimat dan audionya disambung kembali menjadi satu berkas.
Apakah bisa mendapat subtitle dari audio yang sama?
Bisa. Kirim output: "base64" dan subtitles: true, lalu ambil field srt dan words dari respons.
Apa yang dilakukan bila satu server gagal?
Ulangi permintaan dengan server yang lain. Server tidak pernah berpindah otomatis, jadi logika pengulangan ada di kode Anda.
Bisakah asisten AI memakai API ini?
Bisa. Server MCP APIPedia menyediakan tool tts_speak, tts_voices, dan tts_servers yang memanggil endpoint yang sama. Cara menyambungkannya ada di panduan menghubungkan APIPedia ke Claude lewat MCP.
Langkah berikutnya: coba di konsol
Suara panggilan antrean cukup butuh satu request POST /v1/tts dan satu folder cache di backend. Buat kunci di console.apipedia.id, jalankan contoh curl di atas dengan kalimat Anda sendiri, lalu pasang fungsi suaraPanggilan di aplikasi antrean.
Untuk melengkapi alurnya, baca API QR code untuk tiket dan nomor antrean, API Translator untuk pengumuman dua bahasa, dan cara kerja Edge TTS bila Anda ingin memahami teknologi suara neural di baliknya.
Topik: #text to speech #tts #api suara #tutorial #nodejs #python
Tentang penulis
Tim APIPedia — Tim Engineering APIPedia
Tim engineering di balik APIPedia yang membangun dan memelihara API data Indonesia - ongkir, OCR KTP, data wilayah, BMKG, hingga server MCP - dan menulis panduan integrasinya dari pengalaman langsung.