Cara Pasang Sinyal Opt-Out Pelatihan AI di robots.txt (Token __usage_ai-training)
Oleh Tim APIPedia, Tim Engineering APIPedia · Terbit · 11 menit baca
Google, OpenAI, Microsoft, dan Anthropic kini sepakat pada satu token robots.txt. Panduan memasang, menguji, dan menegakkannya.
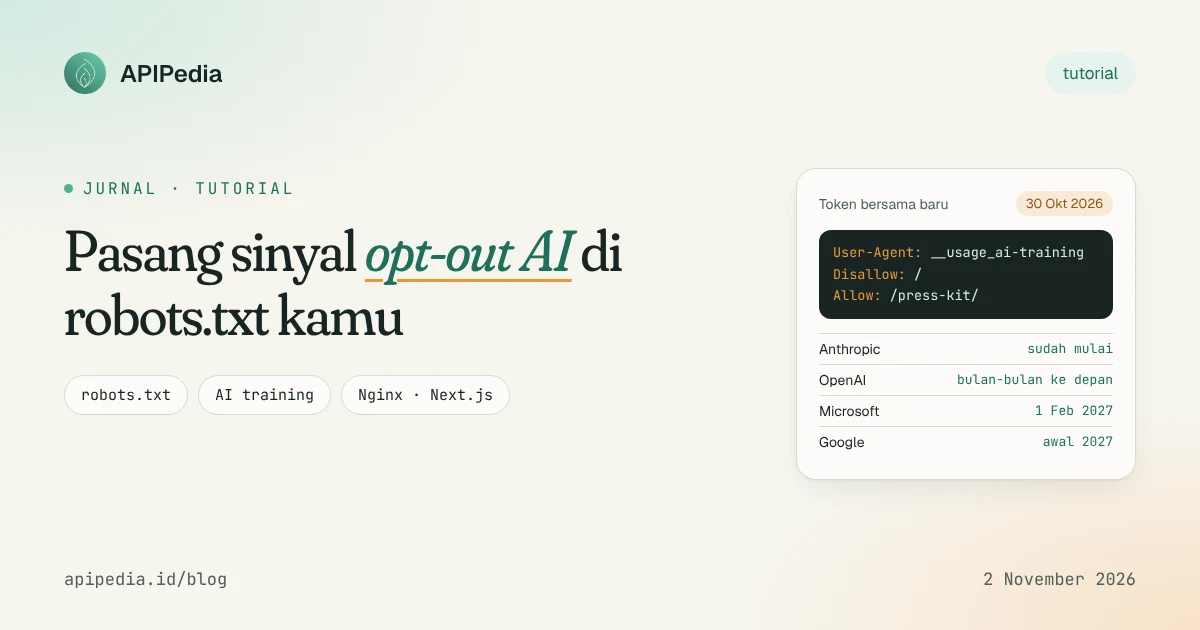
Mulai 30 Oktober 2026, Google, OpenAI, Microsoft, dan Anthropic sepakat menghormati satu token robots.txt bersama, __usage_ai-training, untuk menyatakan apakah konten situsmu boleh dipakai melatih model AI generatif. Satu blok aturan kini bisa menggantikan daftar bot yang terus bertambah, tanpa mengganggu SEO.
Topik ini ramai sejak akhir pekan karena untuk pertama kalinya empat pemain besar memakai satu bahasa yang sama. Tapi dukungannya belum serentak: Anthropic sudah mulai, Microsoft menyusul 1 Februari 2027, Google menargetkan awal 2027, dan OpenAI baru menyebut "dalam beberapa bulan". Artinya, cara memasangnya dengan benar sekarang perlu sedikit strategi.
Panduan ini membahas langkah praktisnya: menulis aturan, memasangnya di Nginx atau Next.js, menguji hasilnya dengan skrip kecil, lalu memantau bot yang nakal. Semua kode sudah kami jalankan sendiri.
Apa sebenarnya token __usage_ai-training?
Ini bukan nama crawler. Token ini adalah policy token: kamu menuliskannya di baris User-Agent seperti biasa, tapi maknanya "aturan untuk tujuan pelatihan AI", siapa pun bot yang mengambil kontennya. Definisinya ada di Internet-Draft individual draft-kelley-aipref-training-preference-signal-00 yang ditulis Kevin Kelley dari Anthropic, terbit 30 Oktober 2026 dan kedaluwarsa 3 Mei 2027 bila tidak diperbarui.
Beberapa aturan main yang penting dipahami sebelum menulis apa pun:
- Grup
User-Agent: *tidak dihitung. Kalau kamu hanya punyaDisallow: /di grup bintang, itu tidak otomatis jadi penolakan training. Token harus ditulis eksplisit. - Tanpa aturan berarti boleh. Situs yang tidak menyatakan preferensi dianggap mengizinkan pelatihan.
- Pencocokan path mengikuti RFC 9309. Aturan dengan path terpanjang yang menang, jadi
Allow: /press-kit/bisa mengalahkanDisallow: /. - Token vendor lebih spesifik. Aturan untuk
GPTBotatauGoogle-Extendedmengalahkan token bersama, sehingga kamu bisa menolak secara umum tapi membuat pengecualian untuk satu vendor. - Bukan soal pencarian. Googlebot dan Bingbot tetap merayapi dan meranking seperti biasa.
Kapan tiap vendor mulai mematuhinya?
Inilah alasan kamu belum boleh menghapus aturan lama. Dukungan datang bertahap, dan tanggalnya adalah rencana yang diumumkan, bukan jaminan.
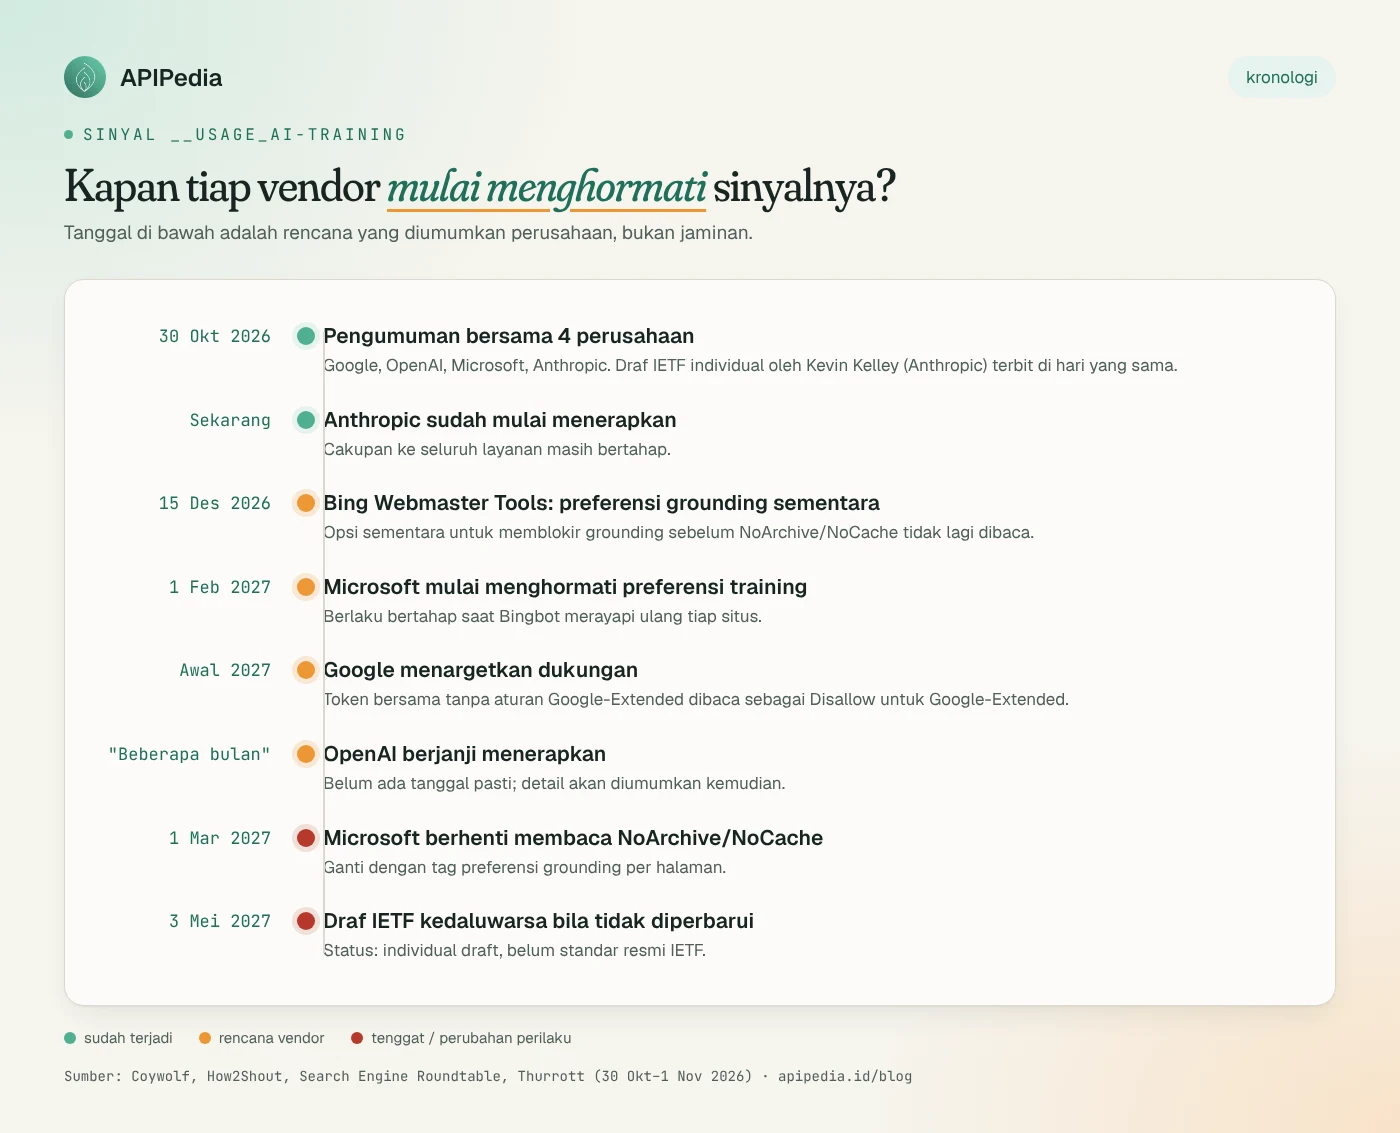
| Vendor | Token lama | Status token bersama | Catatan |
|---|---|---|---|
| Anthropic | ClaudeBot | Sudah mulai diterapkan | Cakupan ke semua layanan masih bertahap |
| OpenAI | GPTBot | "Dalam beberapa bulan" | Detail sintaks akan diumumkan kemudian |
| Microsoft | NoArchive / NoCache | 1 Februari 2027 | Ada preferensi grounding terpisah per halaman |
Google-Extended | Awal 2027 | Token bersama dibaca sebagai Disallow Google-Extended bila Google-Extended tidak disebut | |
| Meta, Apple, Amazon | beragam | Belum berkomitmen | Tetap pakai token masing-masing |
Ada sedikit perbedaan di antara sumber. Coywolf menyebut Anthropic sebagai satu-satunya yang sudah memakai token ini, sedangkan Thurrott menulis ketiga perusahaan lain akan menerapkan "pada 2027", padahal OpenAI sendiri hanya menyebut "dalam beberapa bulan". Kami memakai pernyataan masing-masing vendor seperti yang dikutip media.
Langkah 1: Bagaimana cara melihat robots.txt yang berlaku sekarang?
Mulai dari kondisi nyata. Ambil robots.txt produksi dan cari aturan AI yang sudah ada:
curl -s https://contoh.co.id/robots.txt -o robots-lama.txt
grep -inE "user-agent|disallow|allow" robots-lama.txt
grep -inE "gptbot|google-extended|claudebot|ccbot|__usage_" robots-lama.txt || echo "Belum ada aturan AI"
Catat tiga hal: apakah ada grup * yang terlalu ketat, apakah token vendor sudah ada, dan folder mana yang memang ingin kamu bagikan (misalnya press kit atau dokumentasi publik).
Langkah 2: Bagaimana menulis aturan yang aman untuk masa transisi?
Strategi paling aman sekarang adalah memasang token bersama dan mempertahankan token lama per vendor. Begitu semua vendor mengonfirmasi dukungan, blok lama bisa dirampingkan.
# Situs biasa: semua crawler boleh merayapi
User-Agent: *
Allow: /

# Sinyal bersama: tolak pelatihan AI, kecuali folder press kit
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/

# Token lama per vendor (tetap dipasang sampai semua vendor mendukung sinyal bersama)
User-Agent: GPTBot
Disallow: /

User-Agent: Google-Extended
Disallow: /

User-Agent: ClaudeBot
Disallow: /

Sitemap: https://contoh.co.id/sitemap.xml
Perhatikan satu jebakan: karena grup GPTBot lebih spesifik, folder /press-kit/ tetap tertutup untuk GPTBot. Kalau kamu ingin press kit terbuka untuk semua vendor, tambahkan Allow: /press-kit/ di tiap grup vendor juga. Satu catatan lagi: memblokir GPTBot menghentikan perayapan oleh bot itu, sementara token bersama hanya mengatur pemakaian untuk training.
Langkah 3: Bagaimana memasangnya di Nginx atau Next.js?
Situs statis atau Nginx
Cukup simpan file di root situs, lalu pastikan disajikan sebagai teks biasa:
sudo cp robots.txt /var/www/html/robots.txt
curl -sI https://contoh.co.id/robots.txt | grep -iE "^(HTTP|content-type)"
# Harapan: HTTP/2 200 dan content-type: text/plain
Next.js (App Router)
Kalau robots.txt dibuat dari kode, Next.js menerima string apa pun di userAgent, termasuk token kebijakan:
// app/robots.ts
import type { MetadataRoute } from "next";

export default function robots(): MetadataRoute.Robots {
  return {
    rules: [
      { userAgent: "*", allow: "/" },
      { userAgent: "__usage_ai-training", disallow: "/", allow: "/press-kit/" },
      { userAgent: ["GPTBot", "Google-Extended", "ClaudeBot"], disallow: "/" },
    ],
    sitemap: "https://contoh.co.id/sitemap.xml",
  };
}
Langkah 4: Bagaimana menguji aturannya sebelum deploy?
Banyak parser robots.txt lama tidak paham token kebijakan dan tidak memakai aturan "path terpanjang menang" (parser bawaan Python, misalnya, memakai aturan pertama yang cocok). Skrip Node.js 18+ berikut mengikuti RFC 9309 dan memperlakukan token __usage_* sesuai draf: tidak ikut grup bintang.
// cek-robots.mjs — cek preferensi robots.txt per token (RFC 9309: longest match, Allow menang bila seri)
// Pakai: node cek-robots.mjs <url-robots.txt | file lokal> <token> <path...>
import { readFile } from "node:fs/promises";

const [src, token, ...paths] = process.argv.slice(2);
if (!src || !token || paths.length === 0) {
  console.error("Pakai: node cek-robots.mjs <robots.txt> <token> <path...>");
  process.exit(1);
}

const text = src.startsWith("http")
  ? await (await fetch(src)).text()
  : await readFile(src, "utf8");

// 1) Kelompokkan baris jadi grup: beberapa User-Agent berurutan + aturan di bawahnya
const groups = [];
let cur = null, lastWasUA = false;
for (const raw of text.split(/\r?\n/)) {
  const line = raw.replace(/#.*/, "").trim();
  const m = line.match(/^([A-Za-z-]+)\s*:\s*(.*)$/);
  if (!m) continue;
  const key = m[1].toLowerCase(), val = m[2].trim();
  if (key === "user-agent") {
    if (!lastWasUA) { cur = { agents: [], rules: [] }; groups.push(cur); }
    cur.agents.push(val.toLowerCase());
    lastWasUA = true;
  } else if ((key === "allow" || key === "disallow") && cur) {
    if (val !== "") cur.rules.push({ allow: key === "allow", path: val });
    lastWasUA = false;
  } else {
    lastWasUA = false;
  }
}

// 2) Pilih grup: token persis (case-insensitive). Token kebijakan AI TIDAK ikut grup "*".
const t = token.toLowerCase();
const isPolicyToken = t.startsWith("__usage_");
let rules = groups.filter(g => g.agents.includes(t)).flatMap(g => g.rules);
let source = `grup "${token}"`;
if (rules.length === 0 && !isPolicyToken) {
  rules = groups.filter(g => g.agents.includes("*")).flatMap(g => g.rules);
  source = 'grup "*"';
}
if (rules.length === 0) source = "tidak ada aturan (default: diizinkan)";

// 3) Pencocokan path: dukung * dan $, pilih aturan terpanjang
const toRegex = p =>
  new RegExp("^" + p.replace(/[.+?^{}()|[\]\\]/g, "\\$&").replace(/\*/g, ".*").replace(/\\\$$|\$$/, "$"));

for (const path of paths) {
  let best = null;
  for (const r of rules) {
    if (!toRegex(r.path).test(path)) continue;
    if (!best || r.path.length > best.path.length ||
        (r.path.length === best.path.length && r.allow)) best = r;
  }
  const ok = best ? best.allow : true;
  console.log(`${ok ? "BOLEH " : "DITOLAK"}  ${token}  ${path}  <- ${best ? (best.allow ? "Allow: " : "Disallow: ") + best.path : source}`);
}
Jalankan terhadap file lokal atau URL produksi:
node cek-robots.mjs robots.txt __usage_ai-training /blog/artikel-1 /press-kit/logo.png
node cek-robots.mjs robots.txt Googlebot /blog/artikel-1
node cek-robots.mjs robots.txt GPTBot /press-kit/logo.png
Hasil pada file contoh di atas:
DITOLAK  __usage_ai-training  /blog/artikel-1  <- Disallow: /
BOLEH   __usage_ai-training  /press-kit/logo.png  <- Allow: /press-kit/
BOLEH   Googlebot  /blog/artikel-1  <- Allow: /
DITOLAK  GPTBot  /press-kit/logo.png  <- Disallow: /
Baris terakhir membuktikan jebakan di Langkah 2: GPTBot tetap ditolak di press kit karena grupnya lebih spesifik. Googlebot tetap boleh, jadi SEO aman.
Kenapa robots.txt saja belum cukup?
Karena robots.txt adalah permintaan, bukan pagar. OpenAI sendiri menyebutnya mekanisme koordinasi, bukan kontrol keamanan. Bot yang tidak patuh, atau scraper yang memalsukan User-Agent, akan tetap masuk. Perubahan juga hanya berlaku untuk perayapan berikutnya (robots.txt bisa di-cache hingga 24 jam) dan tidak menarik kembali konten yang sudah terlanjur dipakai melatih model.
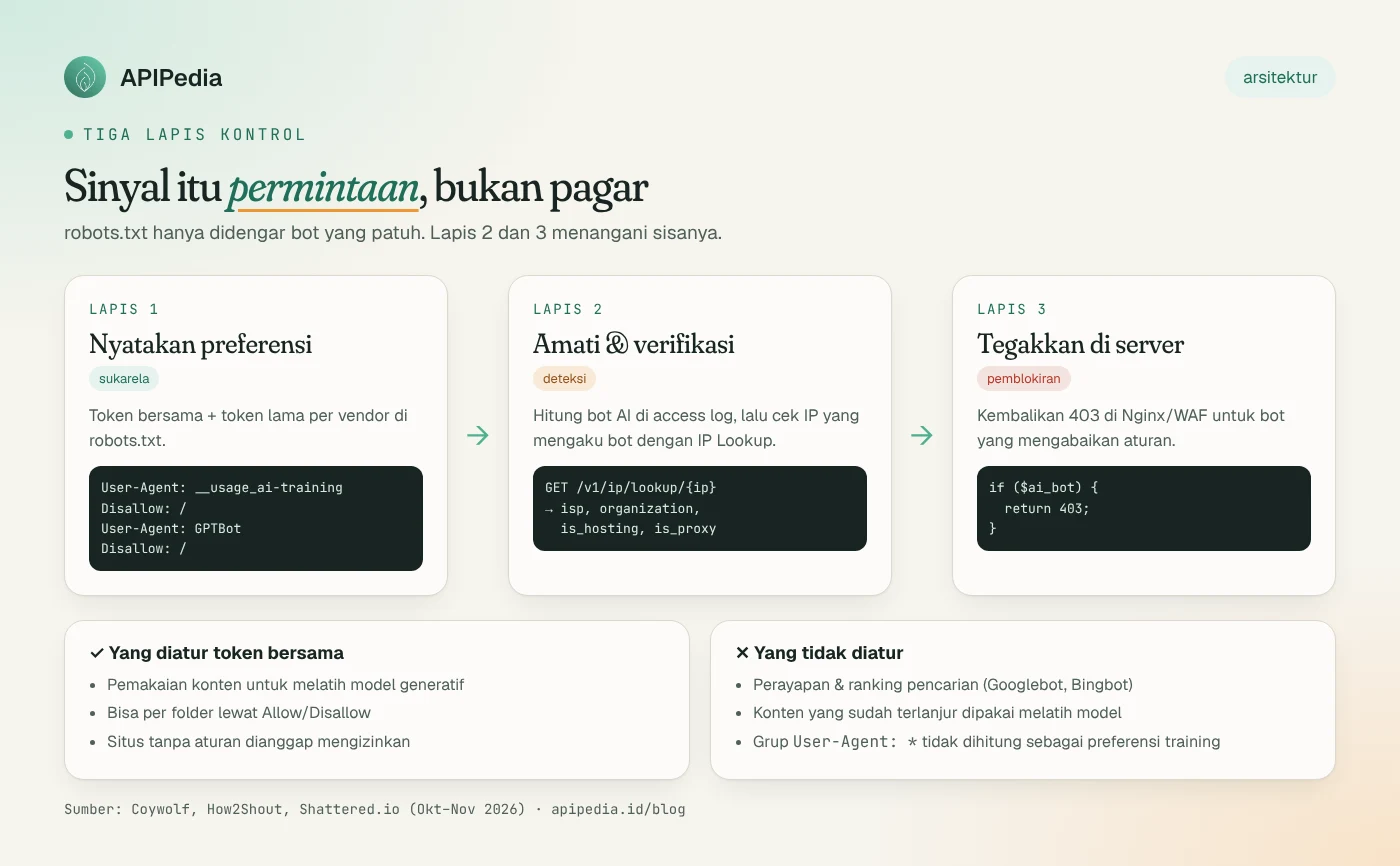
Langkah 5: Bagaimana memantau bot AI di access log?
Untuk format log combined Nginx/Apache, User-Agent ada di kolom keenam bila dipisah tanda kutip:
# Hitung kunjungan per bot AI
awk -F'"' '{print $6}' /var/log/nginx/access.log \
  | grep -oE 'GPTBot|ClaudeBot|CCBot|PerplexityBot|Bytespider|Googlebot|bingbot' \
  | sort | uniq -c | sort -rn

# Daftar IP yang mengaku GPTBot atau ClaudeBot
grep -E 'GPTBot|ClaudeBot' /var/log/nginx/access.log | awk '{print $1}' | sort -u
Siapa pun bisa menulis "ClaudeBot" di User-Agent. Untuk memeriksa apakah IP-nya masuk akal, kamu bisa memakai endpoint IP Lookup APIPedia (GET /v1/ip/lookup/{ip}) yang mengembalikan negara, ISP, organisasi, serta penanda is_hosting dan is_proxy. Kunci API bisa dibuat di console.apipedia.id.
// verifikasi-bot.mjs — cek IP yang mengaku bot AI lewat APIPedia IP Lookup
// Pakai: APIPEDIA_KEY=apk_xxx node verifikasi-bot.mjs access.log
import { readFile } from "node:fs/promises";

const KEY = process.env.APIPEDIA_KEY;
const BOTS = /GPTBot|ClaudeBot|PerplexityBot|CCBot/;
const lines = (await readFile(process.argv[2] ?? "access.log", "utf8")).split("\n");

const ips = new Map(); // ip -> nama bot yang diakui
for (const line of lines) {
  const ua = line.split('"')[5] ?? "";
  const bot = ua.match(BOTS)?.[0];
  if (bot) ips.set(line.split(" ")[0], bot);
}

for (const [ip, bot] of ips) {
  const res = await fetch(`https://api.apipedia.id/v1/ip/lookup/${encodeURIComponent(ip)}`, {
    headers: { Authorization: `Bearer ${KEY}` },
  });
  const { is_success, data, message } = await res.json();
  if (!is_success) { console.log(ip, "gagal:", message); continue; }
  console.log(`${bot.padEnd(10)} ${ip.padEnd(15)} ${data.country} | ${data.isp} | ${data.organization} | hosting=${data.is_hosting}`);
}
APIPEDIA_KEY=apk_xxx node verifikasi-bot.mjs /var/log/nginx/access.logContoh keluaran dari log uji kami:
GPTBot     20.171.207.5    United States | Microsoft Corporation | Microsoft Azure Cloud (westus3) | hosting=true
ClaudeBot  8.8.8.8         United States | Google LLC | Google Public DNS | hosting=true
Baris kedua jelas palsu: IP resolver DNS publik Google tidak mungkin milik crawler Anthropic. Untuk kepastian, bandingkan hasilnya dengan daftar IP resmi yang diterbitkan vendor bila tersedia. IP Lookup membantu menyaring yang mencurigakan, bukan menggantikan daftar resmi itu.
Langkah 6: Bagaimana memblokir bot yang mengabaikan aturan?
Kalau sebuah bot terus datang meski sudah ditolak, tegakkan di server. Konfigurasi Nginx ini sudah kami uji: browser biasa mendapat 200, User-Agent GPTBot mendapat 403, dan robots.txt tetap bisa dibaca semua bot.
# di dalam blok http { }
map $http_user_agent $ai_bot {
    default 0;
    ~*(GPTBot|ClaudeBot|CCBot|Bytespider) 1;
}

server {
    # ... konfigurasi server kamu
    location = /robots.txt { try_files $uri =404; }   # biarkan bot membaca aturan

    location / {
        if ($ai_bot) { return 403; }
        try_files $uri $uri/ =404;
    }
}
sudo nginx -t && sudo systemctl reload nginx
curl -s -o /dev/null -w "%{http_code}\n" -A "Mozilla/5.0 (compatible; GPTBot/1.2)" https://contoh.co.id/
# Harapan: 403Pemblokiran berbasis User-Agent hanya menghentikan bot yang jujur menyebut namanya. Untuk scraper yang menyamar, kamu butuh layanan mitigasi bot di level CDN/WAF. Jika kamu pengguna Cloudflare, ada juga direktif Content-Signal (ai-train, ai-input, search) sebagai pendekatan lain yang masih berjalan paralel.
Checklist singkat
- Tambahkan grup
User-Agent: __usage_ai-trainingsecara eksplisit. - Pertahankan
GPTBot,Google-Extended, danClaudeBotsampai tiap vendor mengonfirmasi dukungan. - Ulangi
Allowpengecualian di setiap grup vendor bila perlu. - Uji dengan
cek-robots.mjssebelum deploy. - Pantau access log dan verifikasi IP yang mencurigakan.
- Pengguna Bing: siapkan tag grounding per halaman sebelum 1 Maret 2027.
Kalau kamu juga sedang menghubungkan agen AI ke API sendiri, panduan menghubungkan APIPedia ke Claude lewat MCP bisa jadi bacaan lanjutan.
FAQ
Apakah token ini memengaruhi ranking Google saya?
Tidak. Token bersama hanya mengatur pemakaian untuk training. Googlebot dan Bingbot tetap merayapi dan mengindeks seperti biasa. Kontrol AI Overviews dan AI Mode di Google punya pengaturan terpisah di Search Console.
Apakah User-Agent: * dengan Disallow: / sudah cukup?
Tidak untuk sinyal ini. Grup bintang tidak dihitung sebagai preferensi training, dan memblokir semua bot juga akan menghapus situsmu dari mesin pencari.
Apakah konten yang sudah dipakai melatih model akan dihapus?
Tidak. Perubahan hanya berlaku untuk perayapan berikutnya. Dataset dan model yang sudah ada tidak terpengaruh.
Apakah ini standar resmi IETF?
Belum. Ini Internet-Draft individual yang dibahas di working group AIPREF. IETF menyatakan draf individual tidak punya kedudukan formal. Draf lain dari Gary Illyes (Google) dan Martin Thomson (Mozilla) mengusulkan aturan Content-Usage di robots.txt dan header HTTP, jadi sintaks akhirnya masih bisa berubah.
Apakah bot di luar empat perusahaan ini ikut patuh?
Tidak ada jaminan. Meta, Apple, dan Amazon belum berkomitmen, dan proyek open-weight atau scraper kecil berada di luar kesepakatan ini. Karena itu lapis pemantauan dan pemblokiran tetap diperlukan.
Sumber
- Coywolf: Google, OpenAI, Microsoft, and Anthropic back a shared robots.txt AI training signal (1 Nov 2026)
- H2S Media: Google, OpenAI, Microsoft and Anthropic Agree on One AI Training Opt-Out
- Search Engine Roundtable: Google AI training control
- Thurrott: Anthropic, Google, Microsoft, and OpenAI Agree to Let Sites Opt Out of AI Training (30 Okt 2026)
- Shattered.io: AI Training Opt-Out: 4 Giants Back One Token
- Search Engine Journal: Gary Illyes tentang robots.txt dan AI training (22 Okt 2026)
- IETF Datatracker: draft-kelley-aipref-training-preference-signal
Topik: #robots-txt #ai #seo #nginx #tutorial
Tentang penulis
Tim APIPedia — Tim Engineering APIPedia
Tim engineering di balik APIPedia yang membangun dan memelihara API data Indonesia - ongkir, OCR KTP, data wilayah, BMKG, hingga server MCP - dan menulis panduan integrasinya dari pengalaman langsung.