Mistral Large 4 Open-Weight: Model 1 Triliun Parameter yang Kini Bisa Diunduh
Oleh Tim APIPedia, Tim Engineering APIPedia · Terbit · 8 menit baca
Mistral merilis bobot model 1 triliun parameter. Ini cara kerja MoE-nya, kebutuhan GPU, mitos vs fakta benchmark, dan jebakan lisensinya.
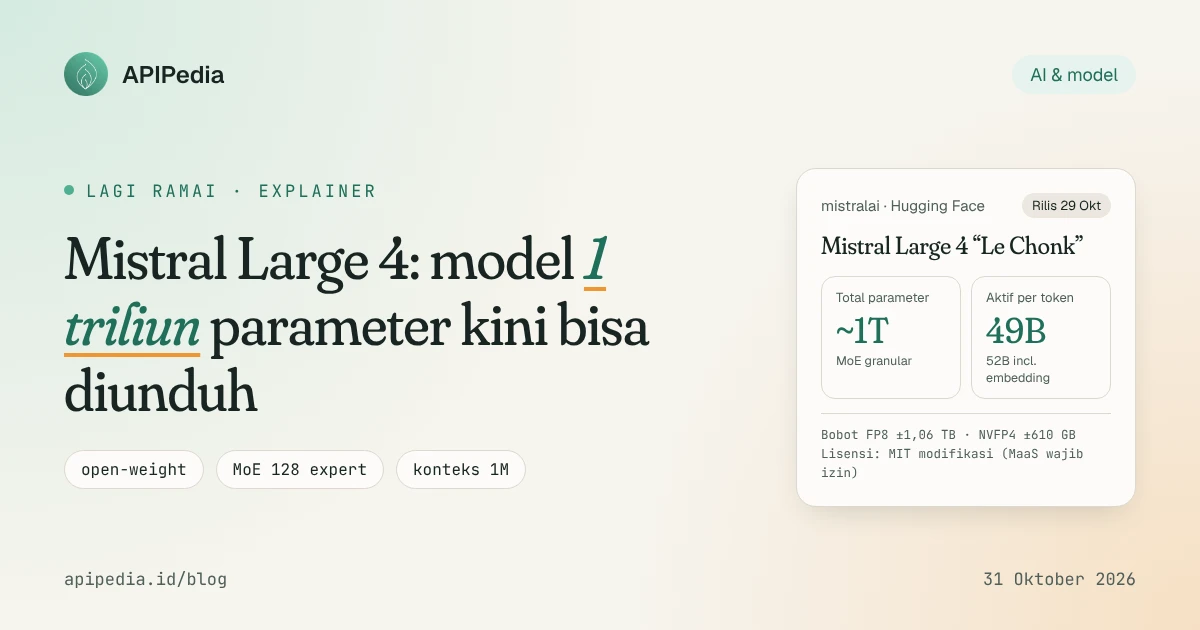
Mistral Large 4 adalah model AI open-weight berukuran sekitar 1 triliun parameter yang bobotnya dirilis Mistral AI di Hugging Face pada 29 Oktober 2026. Model ini ramai karena bisa diunduh dan dijalankan sendiri, menyasar coding dan keamanan siber, tapi tetap butuh server multi-GPU dan punya syarat lisensi khusus untuk bisnis API.
Dua hari terakhir, nama "Le Chonk" (julukan internal Mistral untuk model ini) muncul di mana-mana, dari TechCrunch sampai digest berita AI harian dan komunitas pengguna model lokal. Artikel ini merangkum apa yang sebenarnya dirilis, cara kerja arsitekturnya, mana yang klaim vendor dan mana yang sudah diverifikasi, serta apa artinya buat developer di Indonesia.
Apa yang sebenarnya dirilis?
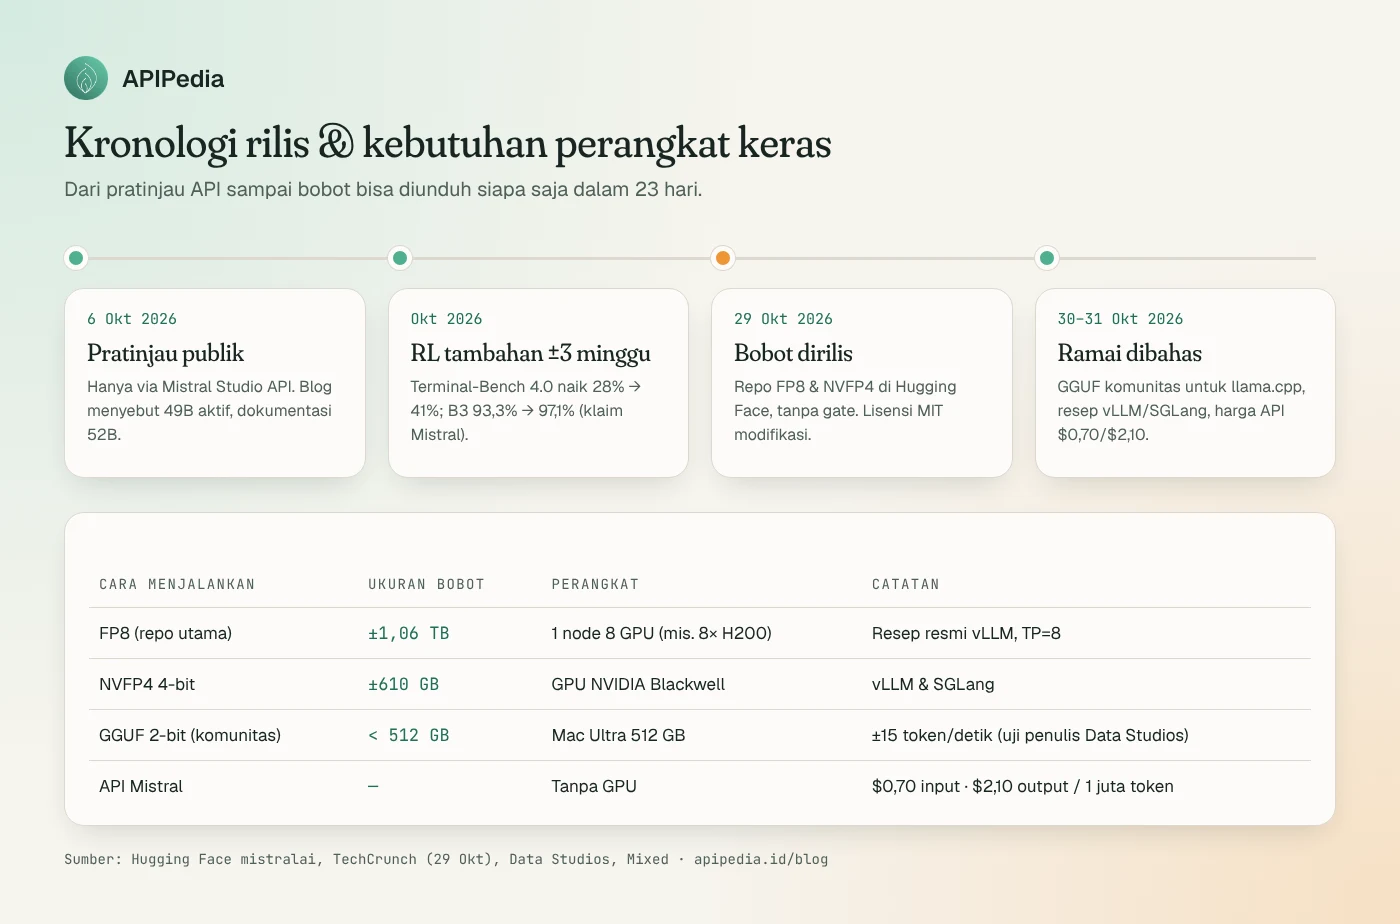
Mistral pertama kali membuka public preview Mistral Large 4 pada 6 Oktober 2026, hanya lewat API di Mistral Studio. Saat itu Mistral berjanji bobotnya menyusul "akhir bulan". Janji itu ditepati: pada 29 Oktober, dua repositori muncul di akun mistralai di Hugging Face.
- mistralai/Mistral-Large-4-1T-A52B: checkpoint utama format FP8, 68 file, total sekitar 1,06 TB.
- mistralai/Mistral-Large-4-1T-A52B-NVFP4: versi kuantisasi 4-bit untuk GPU NVIDIA Blackwell, sekitar 610 GB.
Keduanya tidak di-gate: siapa pun bisa mengunduh tanpa mengisi formulir. Model card juga menyebut checkpoint ini membawa draft head bernama DSpark untuk speculative decoding, dan komunitas llama.cpp sudah menyediakan file GGUF.
Kepada TechCrunch, Pierre Stock (VP of Science Mistral) menekankan bahwa akses ke model open-weight "tidak bisa diputus", sehingga perusahaan dan pemerintah bisa menjalankannya di server sendiri untuk mendeteksi dan merespons insiden keamanan.
Kenapa ramai dibicarakan?
Ada beberapa alasan yang saling menguatkan:
- Ukurannya. Model open-weight 1 triliun parameter dari lab Barat masih jarang. Selama ini model terbuka terbesar banyak datang dari lab Tiongkok seperti GLM, Kimi, dan DeepSeek.
- Fokus keamanan siber. Saat lab lain membatasi model berkemampuan siber tinggi ke kelompok terpilih, Mistral justru membagikan bobotnya ke publik dengan argumen "pertahanan siber berdaulat".
- Harga API turun. Saat preview, harga tercatat $1,36 per juta token input dan $4,18 output. Per 30 Oktober, Data Studios mencatat $0,70 input dan $2,10 output setelah masa diskon peluncuran berakhir.
- Kontroversi kecil soal angka. Blog peluncuran awal menyebut 49 miliar parameter aktif, sementara dokumentasi menyebut 52 miliar. Model card akhirnya menjelaskan: 49B aktif, atau 52B jika embedding dan lapisan output ikut dihitung.
Bagaimana cara kerja Mixture-of-Experts di model ini?
Mistral Large 4 memakai arsitektur Mixture-of-Experts (MoE) yang granular. Bayangkan sebuah kantor dengan 128 spesialis. Untuk setiap token (potongan kata), sebuah "router" hanya memanggil 4 spesialis yang paling cocok, ditambah 1 spesialis umum (shared expert) yang selalu ikut bekerja.
Akibatnya, komputasi per token hanya melibatkan sekitar 49 miliar parameter, bukan 1 triliun. Itu sebabnya model ini bisa cukup cepat dan murah dioperasikan untuk ukurannya.
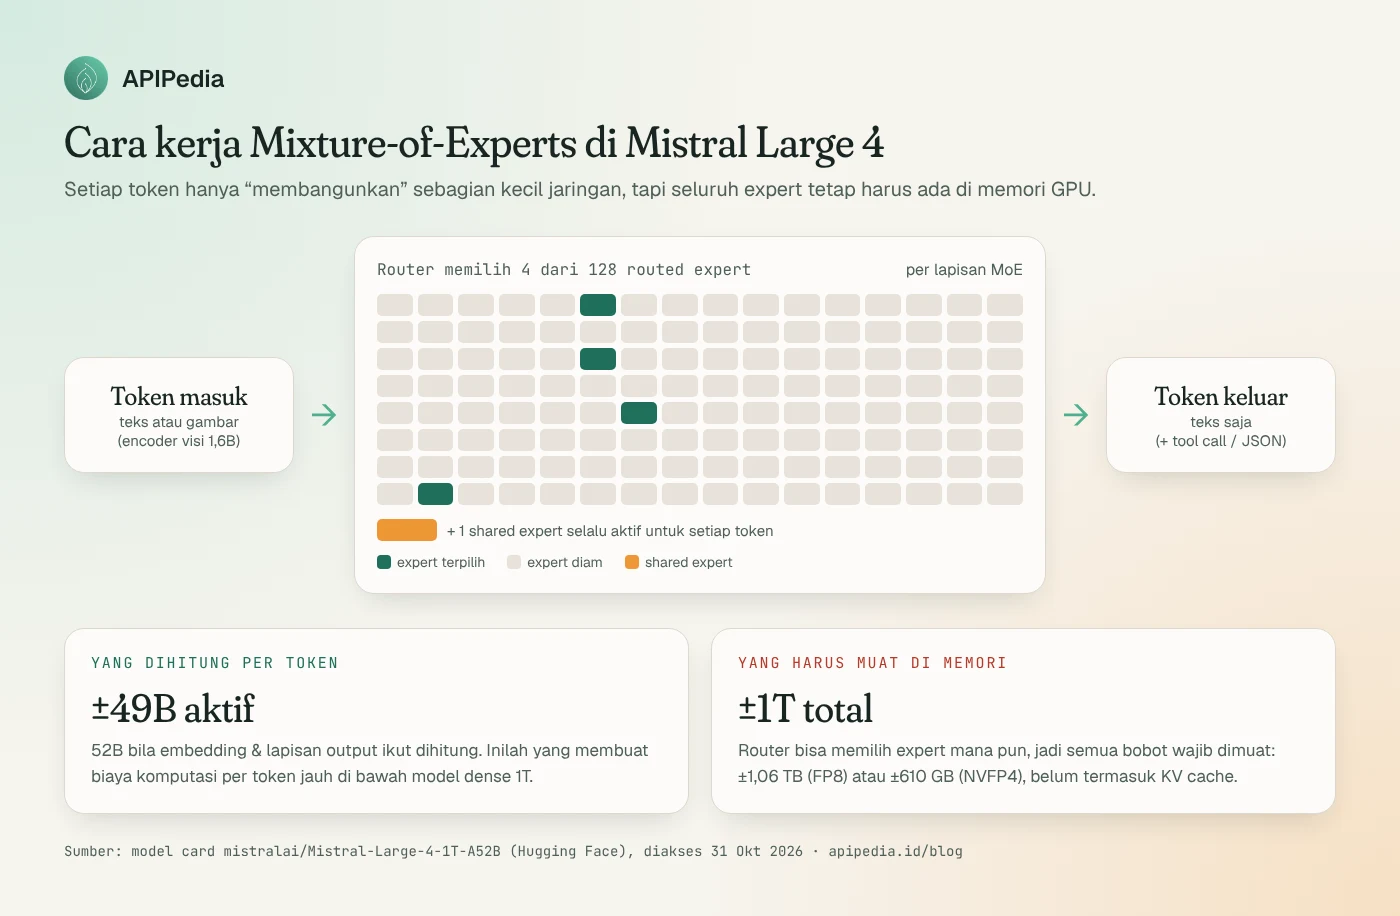
Tapi ada jebakan yang sering terlewat: semua expert tetap harus ada di memori. Router bisa memilih expert mana saja untuk token berikutnya, jadi seluruh bobot 1 triliun parameter wajib dimuat ke GPU. Parameter aktif menentukan kecepatan, sedangkan parameter total menentukan berapa banyak memori yang kamu butuhkan.
Spesifikasi kunci
| Aspek | Mistral Large 4 | Sumber |
|---|---|---|
| Total parameter | ~1T (dokumentasi: 1,05T) | Model card, docs Mistral |
| Parameter aktif | 49B (52B termasuk embedding & output) | Model card |
| Expert | 128 routed (4 aktif) + 1 shared | Model card |
| Konteks | 1 juta token | Model card |
| Modalitas | Input teks & gambar, output teks | Model card |
| Mode reasoning | low / medium / high (default high) | Model card |
| Bahasa | 160+ bahasa, termasuk Indonesia | Model card |
| Pelatihan | 3.800 GPU NVIDIA Grace Blackwell di Eropa | Mistral, TechCrunch |
| Harga API | $0,70 input · $0,07 cached · $2,10 output / 1 juta token | Data Studios (30 Okt) |
Seberapa pintar? Mitos vs fakta
Di media sosial, klaimnya beragam: dari "setara model tertutup terbaik" sampai "kalah jauh dari model Tiongkok". Berikut yang bisa dipegang:
- Mitos: "Model open-weight terbaik di semua bidang." Fakta: di Artificial Analysis Intelligence Index v5, Mistral sendiri melaporkan skor 26, tertinggi di antara model open-weight Barat. Mistral mengakui model terbuka terbaik dari Tiongkok masih unggul di indeks gabungan itu.
- Mitos: "Coding-nya setara model frontier tertutup." Fakta: di Artificial Analysis Coding Agent Index, skornya 48%, kira-kira seri dengan GLM-5.3 tetapi dengan 47% lebih sedikit token per tugas. Itu soal efisiensi, bukan berarti menyalip model tertutup teratas.
- Mitos: "Model siber terbuka = senjata untuk penyerang." Fakta: Mistral mengklaim rata-rata tingkat penolakan 96,6% untuk permintaan siber berbahaya (JailbreakBench, StrongREJECT, AgentHarm). Namun ini angka internal, dan Mistral menyebut guardrail sibernya masih disesuaikan, sehingga perilaku bobot yang di-host sendiri bisa berbeda dari API.
- Mitos: "Angkanya sudah diuji independen." Fakta: sebagian besar benchmark (Terminal-Bench 4.0 41%, B3 97,1%, FrontierCode 2.0 19,7%) dilaporkan oleh Mistral atau mitranya. Evaluasi independen atas checkpoint yang bisa diunduh belum banyak terbit.
Perlu dicatat, skor indeks yang beredar berbeda-beda karena versi indeksnya berbeda. Saat preview, beberapa media mengutip skor 38 di Intelligence Index versi sebelumnya, sedangkan model card memakai v5 dengan skor 26. Jangan bandingkan dua angka itu secara langsung.
Bisakah dijalankan sendiri?
Bisa, tapi bukan di laptop. Resep resmi vLLM memakai satu node 8 GPU dengan tensor parallelism 8, dan Hugging Face Inference Endpoints memakai 8× NVIDIA H200. Versi NVFP4 butuh GPU generasi Blackwell.
Sebelum mengunduh, cek dulu ukuran repositori lewat API publik Hugging Face supaya tidak kaget:
# Hitung total ukuran file di repo (butuh curl + jq)
curl -s "https://huggingface.co/api/models/mistralai/Mistral-Large-4-1T-A52B?blobs=true" \
  | jq '[.siblings[].size] | add / 1e9 | floor | "\(.) GB"'

# Unduh hanya config dan lisensi dulu untuk dibaca
hf download mistralai/Mistral-Large-4-1T-A52B config.json LICENSE --local-dir ./ml4
Kalau kamu memang punya node GPU yang memadai, perintah serve dari model card terlihat seperti ini:
docker run --runtime nvidia --gpus all \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  -p 8000:8000 --ipc=host \
  vllm/vllm-openai:mistral-large-4 \
  --model mistralai/Mistral-Large-4-1T-A52B \
  --tensor-parallel-size 8 \
  --tool-call-parser mistral \
  --reasoning-parser mistral \
  --enable-auto-tool-choice \
  --gpu-memory-utilization 0.85
Untuk kebanyakan tim, jalur paling realistis tetap API. Model ini tersedia di Mistral API dengan ID mistral-large-4, juga di OpenRouter, NVIDIA NIM, dan Microsoft Foundry. Contoh panggilan sederhana:
curl https://api.mistral.ai/v1/chat/completions \
  -H "Authorization: Bearer $MISTRAL_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "mistral-large-4",
    "reasoning_effort": "medium",
    "temperature": 1.0,
    "top_p": 0.95,
    "messages": [
      {"role": "user", "content": "Jelaskan risiko SQL injection dalam 3 poin, bahasa Indonesia."}
    ]
  }'
Model card merekomendasikan temperature=1.0 dan top_p=0.95 untuk semua level reasoning. Ingat juga bahwa pada server vLLM, max_completion_tokens menghitung token reasoning, bukan hanya jawaban yang terlihat.
Lisensinya benar-benar bebas?
Hampir. Mistral memakai Mistral Ecosystem Open-Weight License, yaitu lisensi MIT yang dimodifikasi. Kamu boleh memakai, memodifikasi, fine-tune, dan menjualnya secara komersial, dengan satu pengecualian besar: bisnis Model-as-a-Service wajib mengurus lisensi komersial terpisah dengan Mistral.
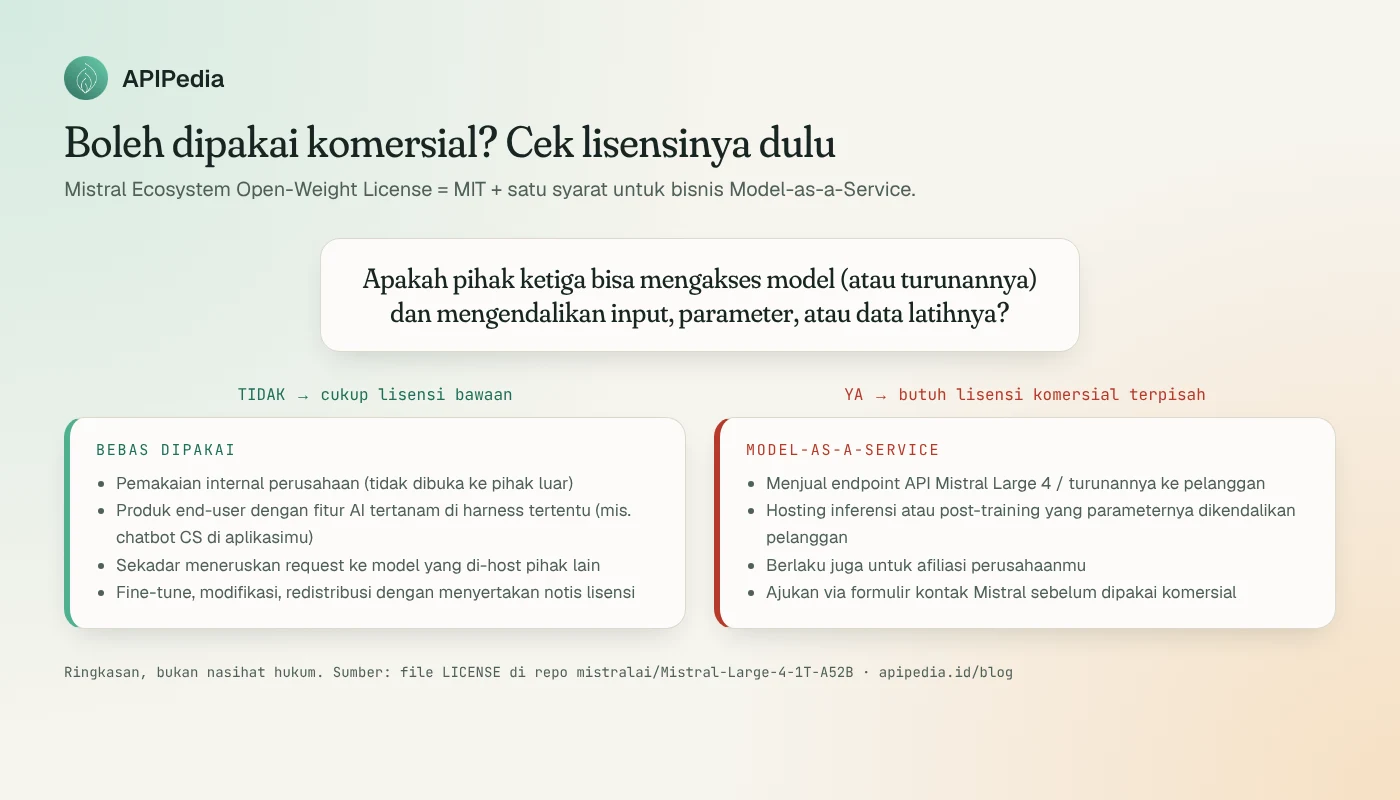
Definisi MaaS di file LICENSE cukup spesifik: memberi pihak ketiga akses inferensi atau post-training dengan kendali berarti atas input, parameter, atau data latih. Produk end-user yang hanya menanamkan kemampuan model di fitur tertentu, pemakaian internal, dan sekadar meneruskan request ke model yang di-host pihak lain tidak termasuk. Ini ringkasan, bukan nasihat hukum; baca teks lisensinya langsung bila kamu berencana menjual akses API.
Apa artinya untuk developer Indonesia?
- Data sensitif bisa tetap on-premise. Bank, rumah sakit, atau instansi yang tidak boleh mengirim data ke luar negeri kini punya opsi model kelas atas yang dijalankan di pusat data sendiri, asalkan sanggup menyediakan GPU-nya.
- Bahasa Indonesia ikut didukung. Model card mencantumkan
iddanmsdi daftar bahasanya, meski belum ada benchmark khusus bahasa Indonesia yang dipublikasikan. - Cocok untuk agen. Dukungan function calling, JSON schema ketat, dan konteks 1 juta token membuatnya layak dicoba untuk agen yang memanggil banyak API, misalnya agen yang memanggil data wilayah, kurs, atau hari libur lewat MCP APIPedia.
- Bandingkan biaya total, bukan harga per token. Saat preview, Artificial Analysis mencatat model ini sangat "cerewet" (sekitar 200 juta token output saat evaluasi). Token reasoning ikut ditagih, jadi uji dengan beban kerja nyata sebelum migrasi.
Kalau kamu sedang menimbang model lain, lihat juga ulasan kami tentang GPT-6 dan Claude Haiku 5.5.
FAQ
Apakah Mistral Large 4 gratis?
Bobotnya gratis diunduh dari Hugging Face. Yang berbayar adalah perangkat keras untuk menjalankannya, atau API Mistral seharga $0,70 per juta token input dan $2,10 per juta token output (per 30 Oktober 2026).
Apakah bisa jalan di PC gaming atau MacBook biasa?
Tidak secara praktis. Versi FP8 butuh sekitar 1,06 TB memori untuk bobot saja. Uji coba komunitas dengan GGUF 2-bit di Mac berchip M3 Ultra dengan memori 512 GB menghasilkan sekitar 15 token per detik, dan itu sudah mesin kelas atas.
Apa beda 49B dan 52B parameter aktif?
Keduanya benar dengan cara hitung berbeda. 49 miliar adalah parameter aktif di blok transformer, sedangkan 52 miliar sudah termasuk lapisan embedding dan output. Nama repo memakai angka 52B ("A52B").
Apakah boleh dipakai di produk SaaS saya?
Kalau model hanya menjadi fitur di dalam produkmu (misalnya ringkasan dokumen di aplikasi), umumnya masuk kategori yang dikecualikan. Kalau kamu menjual akses API ke model itu sendiri sehingga pelanggan mengendalikan input dan parameternya, itu Model-as-a-Service dan butuh lisensi komersial dari Mistral.
Apakah benchmark-nya bisa dipercaya?
Perlakukan sebagai klaim vendor sampai ada evaluasi independen atas checkpoint publik. Mistral sendiri mengakui model terbuka dari Tiongkok masih unggul di indeks kecerdasan gabungan.
Sumber
- Model card & LICENSE Mistral-Large-4-1T-A52B (Hugging Face)
- TechCrunch: Mistral releases weights for its trillion-parameter AI model, targeting cybersecurity (29 Okt 2026)
- Data Studios: Mistral Large 4 open weights, 1M context, license, benchmarks and API pricing
- Mixed: Mistral's blog says 49 billion active parameters, its docs say 52 billion
- Noze: Mistral Large 4 architecture, benchmarks and open weights
- DEV Community: AI Daily Digest 30 Oktober 2026
Topik: #mistral #llm #open-weight #ai #hugging-face
Tentang penulis
Tim APIPedia — Tim Engineering APIPedia
Tim engineering di balik APIPedia yang membangun dan memelihara API data Indonesia - ongkir, OCR KTP, data wilayah, BMKG, hingga server MCP - dan menulis panduan integrasinya dari pengalaman langsung.