Token AI Itu Seperti Pulsa: Cara Kerja Tokenizer, Input dan Output Token, dan Kenapa Langganan Juga Ada Batasnya
Oleh Tim APIPedia, Tim Engineering APIPedia · Terbit · 9 menit baca
Token adalah "pulsa" AI: satuan yang dipakai model untuk membaca dan menulis teks, sekaligus satuan tagihan. Begini cara kerjanya dan cara menghematnya.
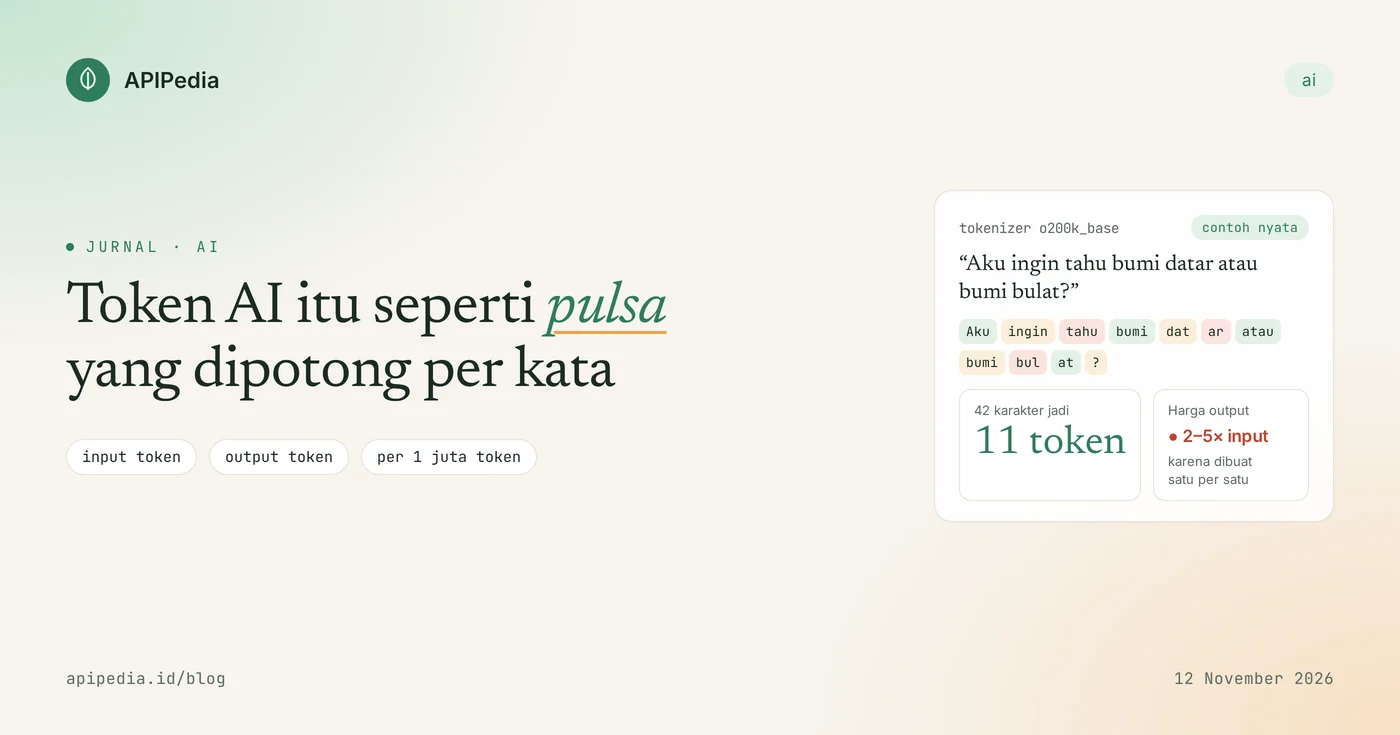
Token adalah satuan terkecil yang dipakai model AI (LLM) untuk membaca dan menulis teks, sekaligus satuan yang dipakai penyedia AI untuk menagih Anda. Cara paling gampang memahaminya: token itu seperti pulsa. Setiap kali Anda bertanya ke AI, ada token yang terpakai untuk membaca pertanyaan Anda, dan ada token yang terpakai untuk menulis jawabannya.
Bedanya dengan pulsa telepon yang dihitung per menit atau per SMS, token dihitung per potongan kata. Artikel ini membahas apa itu token, bagaimana kalimat diubah jadi angka, di mana posisi chunking, vektor, dan embedding, apa sebenarnya yang Anda bayar, dan kenapa langganan AI bulanan pun tetap punya batas pemakaian.
Ringkasan cepat: apa yang perlu Anda tahu?
| Istilah | Artinya |
|---|---|
| Token | Potongan teks: bisa satu kata utuh, sebagian kata, tanda baca, atau spasi plus kata |
| Tokenizer | Alat yang memecah teks menjadi token lalu mengubahnya menjadi ID angka |
| Detokenizer (decode) | Kebalikannya: mengubah ID token hasil model kembali menjadi teks |
| Input token | Semua yang Anda kirim ke model: pertanyaan, instruksi, riwayat chat, dokumen yang ditempel |
| Output token | Semua yang ditulis model, termasuk "token berpikir" pada model reasoning |
| Satuan harga | Umumnya per 1 juta token, dengan tarif input dan output yang berbeda |
| Patokan kasar | Bahasa Inggris: 1 token ≈ 4 karakter. Bahasa Indonesia sering butuh sedikit lebih banyak token |
Apa itu token?
Model AI tidak membaca huruf seperti manusia. Sebelum diproses, teks dipecah menjadi potongan-potongan yang sudah dikenal model. Potongan ini bisa sependek satu karakter atau sepanjang satu kata, tergantung bahasa dan konteksnya. Spasi, tanda baca, dan potongan kata semuanya ikut dihitung.
Kami mencoba kalimat "Aku ingin tahu bumi datar atau bumi bulat?" dengan tokenizer o200k_base (dipakai model-model OpenAI terbaru). Hasilnya, 42 karakter dipecah menjadi 11 token:
| Potongan | ID token |
|---|---|
Aku | 171505 |
ingin | 55202 |
tahu | 71666 |
bumi | 158485 |
dat + ar | 1814, 277 |
atau | 18227 |
bumi | 158485 |
bul + at | 7750, 266 |
? | 30 |
Ada tiga hal menarik dari contoh ini. Pertama, kata "bumi" muncul dua kali dengan ID yang sama, karena tokenizer selalu memetakan potongan yang sama ke angka yang sama. Kedua, kata "datar" dan "bulat" dipecah jadi dua potongan, karena kata itu tidak ada utuh di kamus tokenizer. Ketiga, spasi biasanya menempel di depan kata, jadi " ingin" dan "ingin" bisa punya ID berbeda.
Token tidak sama dengan karakter atau kata
Untuk teks bahasa Inggris, OpenAI memberi patokan kasar: 1 token kira-kira 4 karakter, atau sekitar ¾ kata. Bahasa lain bisa berbeda. Dari uji kami dengan tokenizer yang sama, kalimat "Bagaimana cara mengecek ongkos kirim dari Surabaya ke Jakarta?" (62 karakter) menjadi 15 token, sedangkan versi Inggrisnya (58 karakter) hanya 13 token. Kata seperti "Bagaimana", "ongkos", dan "kirim" dipecah jadi beberapa potongan.
Setiap model juga punya tokenizer sendiri. Teks yang sama bisa menghasilkan jumlah token berbeda di model berbeda. Artinya, harga per 1 juta token yang lebih murah belum tentu berarti total biaya lebih murah.
Bagaimana pertanyaan Anda diproses sampai jadi jawaban?
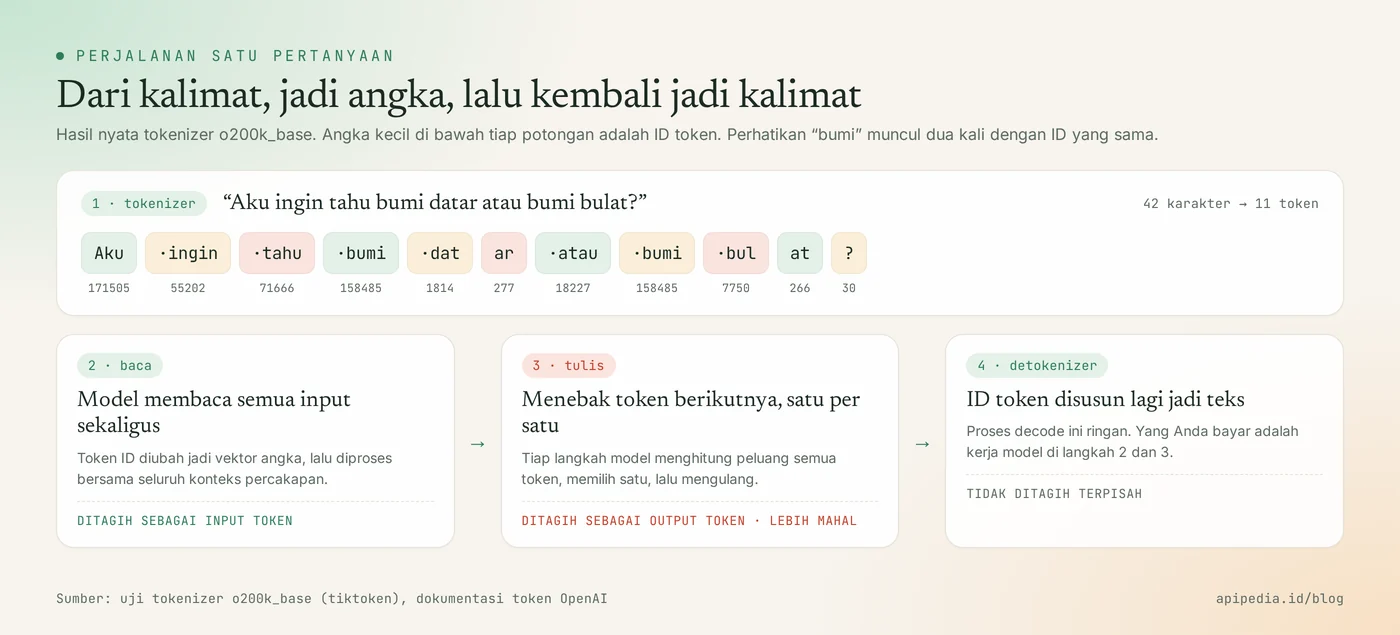
- Tokenizer. Kalimat Anda dipecah menjadi token dan diubah menjadi deretan ID angka.
- Model membaca. Setiap ID diubah menjadi vektor (deretan angka panjang yang mewakili makna), lalu diproses bersama seluruh konteks: instruksi sistem, riwayat chat, dan pertanyaan Anda. Semua ini dihitung sebagai input token.
- Model menulis. Model tidak langsung mengeluarkan satu paragraf. Ia menghitung peluang untuk semua token yang mungkin muncul berikutnya, memilih satu, menambahkannya ke konteks, lalu mengulang sampai jawaban selesai. Setiap token yang dihasilkan dihitung sebagai output token.
- Detokenizer. Deretan ID hasil model diubah kembali menjadi teks yang bisa Anda baca. Proses ini sering disebut decode atau detokenisasi.
Lalu chunking, vektor, dan embedding itu di mana?
Istilah ini sering tercampur dengan proses di atas, padahal posisinya berbeda. Chat biasa tidak melewati pencarian data: model menjawab dari pengetahuan hasil training yang tersimpan di dalam bobot model, bukan mencari ke basis data setiap kali ditanya.
Chunking, embedding, dan pencarian kemiripan baru dipakai saat Anda ingin AI menjawab berdasarkan dokumen Anda sendiri, misalnya FAQ toko, katalog produk, atau SOP kantor. Teknik ini disebut RAG (Retrieval-Augmented Generation).
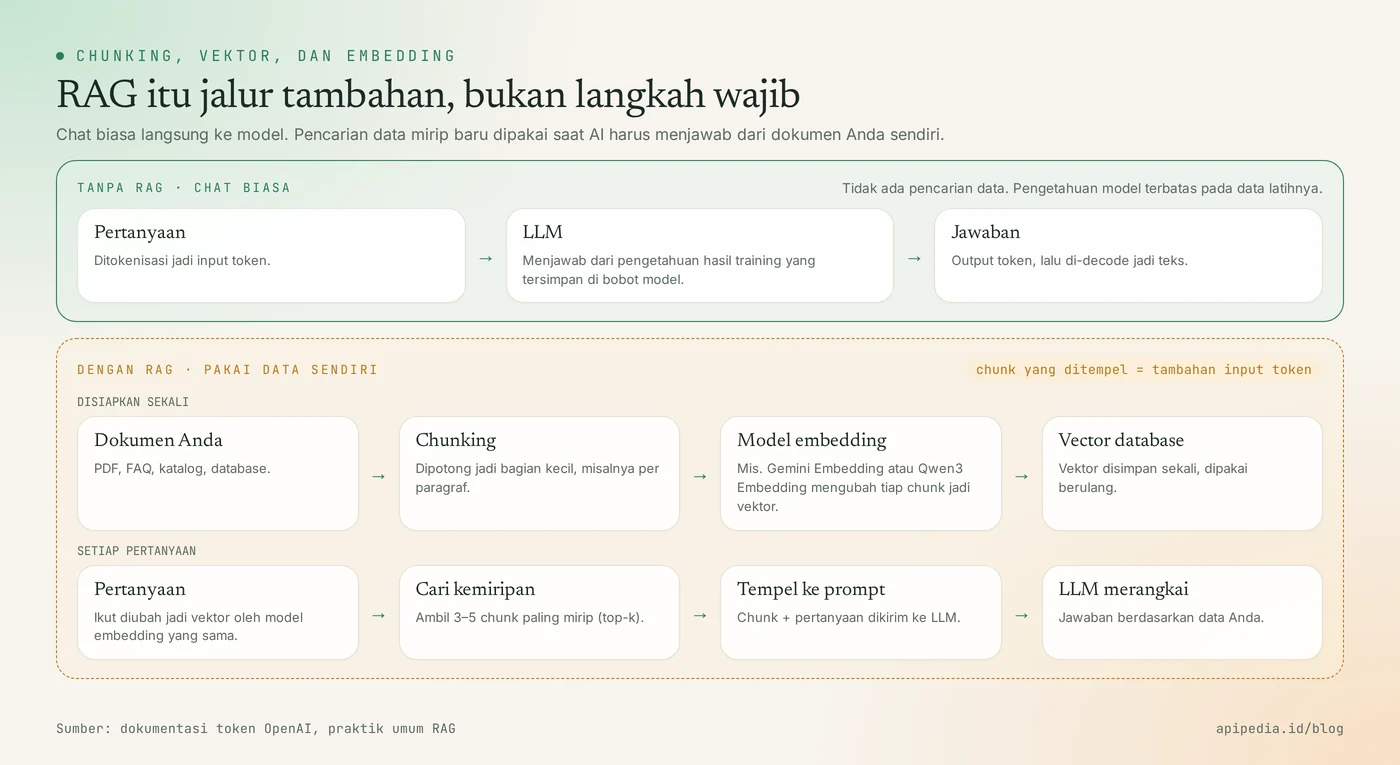
- Chunking. Dokumen dipotong menjadi bagian kecil, misalnya per paragraf atau per beberapa ratus token.
- Embedding. Setiap potongan diubah menjadi vektor oleh model embedding, misalnya Gemini Embedding atau Qwen3 Embedding, lalu disimpan di vector database. Langkah ini dilakukan sekali di awal, bukan setiap kali bertanya.
- Pencarian. Saat ada pertanyaan, pertanyaan itu ikut diubah menjadi vektor dengan model embedding yang sama, lalu dicari potongan yang paling mirip. Biasanya diambil 3 sampai 5 potongan teratas (top-k).
- Dirangkai LLM. Potongan tadi ditempel ke prompt bersama pertanyaan, lalu LLM menyusun jawabannya.
Konsekuensinya untuk biaya: model embedding punya tarif sendiri (biasanya jauh lebih murah dari LLM), dan setiap potongan dokumen yang ditempel ke prompt menambah input token LLM.
Sebenarnya yang kita bayar apa?
Ini bagian yang sering disalahpahami. Proses tokenizer dan detokenizer itu ringan, bahkan bisa dijalankan di laptop biasa dalam hitungan milidetik. Yang mahal adalah kerja model di tengahnya: membaca setiap input token dan menghasilkan setiap output token di server GPU. Token dipakai sebagai satuan ukur karena jumlahnya sebanding dengan beban kerja itu, mirip pulsa yang menjadi satuan ukur pemakaian jaringan.
Karena itu, penyedia API menagih input dan output secara terpisah, biasanya per 1 juta token. Rumus dasarnya:
biaya = (input token × tarif input) + (output token × tarif output)Beberapa aturan yang berlaku di hampir semua penyedia:
- Output lebih mahal dari input, umumnya 2 sampai 5 kali lipat. Input dibaca sekaligus secara paralel, sedangkan output harus dibuat satu token demi satu token.
- Token berpikir ikut ditagih. Pada model reasoning, langkah berpikir internal yang tidak tampil sebagai jawaban tetap dihitung sebagai output token. Jawaban pendek pun bisa memakai banyak token.
- Input yang di-cache lebih murah. Bagian prompt yang sama dan dipakai berulang, seperti instruksi sistem yang panjang, bisa ditagih dengan tarif lebih rendah lewat prompt caching.
- Batch lebih murah. Banyak penyedia memberi potongan sekitar 50% untuk permintaan yang tidak perlu dijawab langsung.
Contoh menghitung token dan biaya
Skrip Python berikut memakai pustaka tiktoken untuk menghitung token, lalu memperkirakan biaya. Tarif di bawah hanya contoh; selalu cek halaman harga resmi model yang Anda pakai.
import tiktoken  # pip install tiktoken

enc = tiktoken.get_encoding("o200k_base")
teks = "Aku ingin tahu bumi datar atau bumi bulat?"
ids = enc.encode(teks)
print(len(teks), "karakter ->", len(ids), "token")
print([enc.decode([i]) for i in ids])

# Estimasi biaya (tarif contoh, dalam USD per 1 juta token)
TARIF_INPUT, TARIF_OUTPUT = 2.00, 10.00
input_tok, output_tok = 1_200, 400
biaya = input_tok / 1e6 * TARIF_INPUT + output_tok / 1e6 * TARIF_OUTPUT
print(f"Estimasi: ${biaya:.4f} per permintaan, ${biaya * 10_000:.2f} untuk 10.000 permintaan")
Hasilnya:
42 karakter -> 11 token
['Aku', ' ingin', ' tahu', ' bumi', ' dat', 'ar', ' atau', ' bumi', ' bul', 'at', '?']
Estimasi: $0.0064 per permintaan, $64.00 untuk 10.000 permintaan
Perhatikan bahwa 400 output token di contoh ini menyumbang $0,004, lebih besar dari 1.200 input token yang hanya $0,0024. Itulah kenapa membatasi panjang jawaban sering lebih menghemat daripada memangkas pertanyaan.
Kenapa chat yang panjang makin boros?
Model tidak "mengingat" percakapan di antara pesan. Agar jawaban nyambung, aplikasi chat mengirim ulang seluruh riwayat percakapan setiap kali Anda mengirim pesan baru. Semua riwayat itu dihitung lagi sebagai input token.
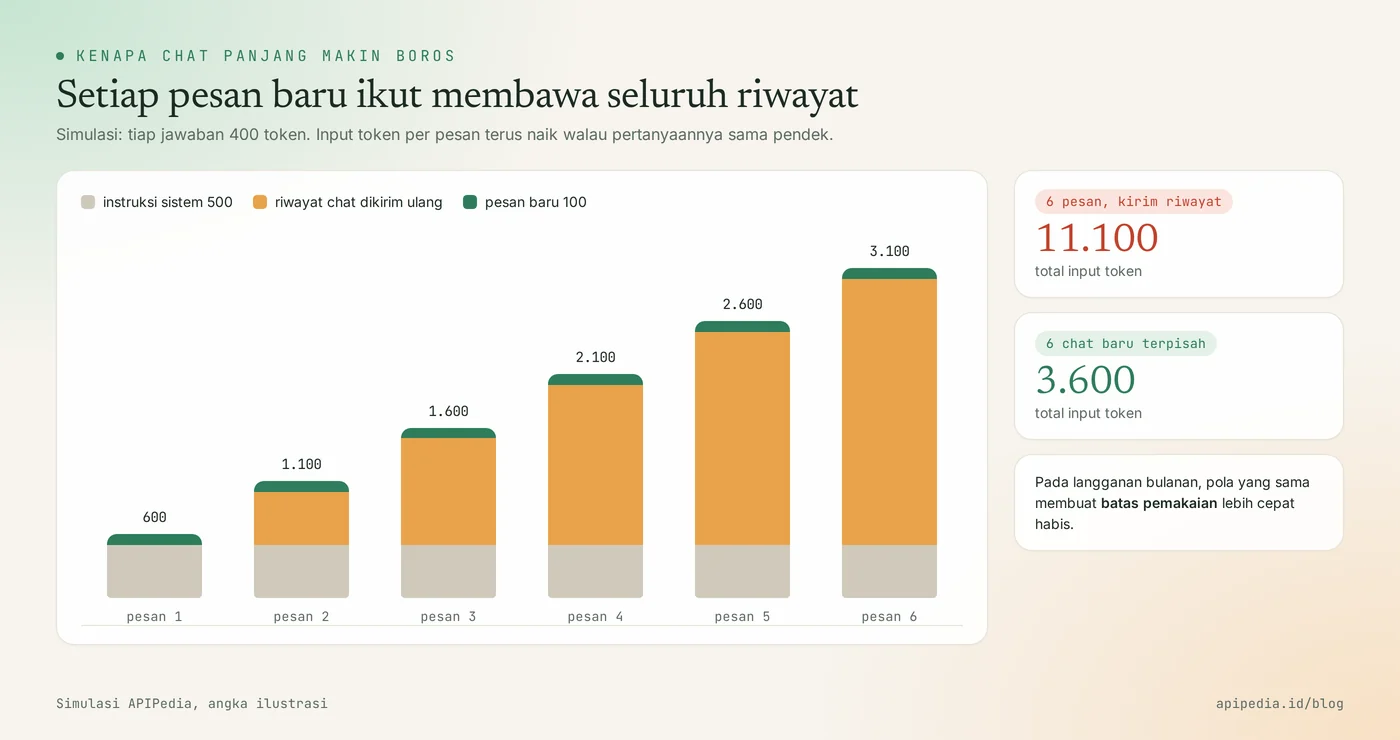
Dalam simulasi di atas, enam pertanyaan pendek di satu chat memakai 11.100 input token, tiga kali lipat lebih banyak dibanding enam chat baru yang terpisah. Makin panjang percakapan dan makin banyak file yang dilampirkan, makin cepat "pulsa" terkuras.
Bagaimana dengan AI yang langganan bulanan?
Langganan bulanan seperti paket internet "unlimited" yang punya batas wajar pemakaian. Anda membayar harga tetap per bulan, tetapi di belakang layar penyedia tetap menghitung token yang Anda pakai, karena biaya server mereka juga dihitung dari situ.
Bentuk batasnya berbeda di tiap layanan. Ada yang mengatur jumlah pesan per beberapa jam, ada yang punya kuota harian atau mingguan, dan ada yang memberi kuota berbeda untuk model yang lebih pintar. Polanya sama: batas itu lebih cepat habis kalau Anda memakai model besar, mengirim percakapan panjang, melampirkan banyak file, atau memakai mode berpikir mendalam. Satu percakapan panjang dengan banyak lampiran bisa menghabiskan kuota yang sama dengan puluhan pertanyaan singkat.
Bedanya dengan API: di langganan, Anda tidak akan ditagih lebih dari harga paket, tetapi akses dibatasi sementara saat kuota habis. Di API, akses tidak dibatasi selama saldo cukup, tetapi tagihan naik sesuai pemakaian.
Tips menghemat token
- Mulai chat baru untuk topik baru. Riwayat yang tidak relevan hanya menambah input token.
- Minta jawaban yang ringkas. Output token adalah bagian termahal. Tulis "jawab maksimal 5 poin" atau setel batas output di API.
- Kirim bagian yang dibutuhkan saja. Daripada menempel dokumen 50 halaman, tempel bagian yang relevan atau pakai RAG.
- Pakai model sesuai tugas. Klasifikasi, ringkasan pendek, dan ekstraksi data sering cukup dengan model kecil yang jauh lebih murah.
- Manfaatkan prompt caching untuk instruksi sistem yang panjang dan dipakai berulang.
- Ukur sebelum memilih model. Hitung token untuk contoh tugas nyata Anda, karena tokenizer tiap model berbeda.
Pertanyaan yang sering diajukan
Apakah yang dibayar itu proses tokenizer-nya?
Bukan. Tokenizer hanya alat pemotong dan penerjemah teks ke angka, prosesnya sangat ringan. Yang Anda bayar adalah kerja model untuk memproses token input dan menghasilkan token output. Token menjadi satuan hitungnya, seperti pulsa menjadi satuan pemakaian jaringan.
Apakah AI selalu mencari data yang mirip sebelum menjawab?
Tidak. Chat biasa menjawab langsung dari pengetahuan yang sudah tersimpan di model saat training. Pencarian 3 sampai 5 data yang paling mirip hanya terjadi pada sistem RAG, yaitu saat aplikasi sengaja menyambungkan AI ke dokumen atau database tertentu.
Kenapa bahasa Indonesia bisa lebih mahal dari bahasa Inggris?
Tokenizer kebanyakan model dilatih dengan data yang didominasi bahasa Inggris, sehingga kata bahasa Inggris lebih sering tersimpan utuh. Kata bahasa Indonesia, terutama yang berimbuhan, lebih sering dipecah menjadi beberapa token. Selisihnya tidak selalu besar, tetapi terasa pada volume tinggi.
Satu juta token itu kira-kira seberapa banyak?
Dengan patokan bahasa Inggris (1 token ≈ ¾ kata), satu juta token setara sekitar 750.000 kata, atau beberapa buku tebal. Untuk bahasa Indonesia, jumlah katanya sedikit lebih sedikit.
Apakah gambar dan file juga dihitung token?
Ya. Gambar, PDF, dan file lain juga diubah menjadi token (atau dihitung setara token) sebelum diproses model. Cara hitungnya berbeda per penyedia, jadi lampiran besar bisa cepat menghabiskan kuota.
Kalau Anda ingin menyambungkan Claude atau agen AI lain ke data Indonesia, baca juga panduan menghubungkan APIPedia ke Claude lewat MCP. Setiap panggilan tool di sana juga ikut menambah token, jadi tips hemat di atas tetap berlaku.
Sumber
- OpenAI Help Center: What are tokens and how to count them?
- GitHub: openai/tiktoken, tokenizer BPE untuk model OpenAI
- BenchLM: LLM Token Pricing, cara kerja harga input dan output
- CloudZero: LLM API Pricing, perbandingan tarif dan diskon batch serta caching
- arXiv: Tokenizations for Austronesian Language Models, studi tokenisasi bahasa di Indonesia
Topik: #ai #llm #token #tokenizer #rag #explainer
${c.about}
Tim APIPedia — Tim Engineering APIPedia
Tim engineering di balik APIPedia yang membangun dan memelihara API data Indonesia - ongkir, OCR KTP, data wilayah, BMKG, hingga server MCP - dan menulis panduan integrasinya dari pengalaman langsung.