Apa Itu Decision Model? AI yang Memutuskan, Bukan Mengobrol
Oleh Tim APIPedia, Tim Engineering APIPedia · Terbit · 6 menit baca
Decision model adalah AI yang memilih jawaban dari daftar tetap plus probabilitas. Pahami cara kerja, kalibrasi, dan pilihan modelnya.
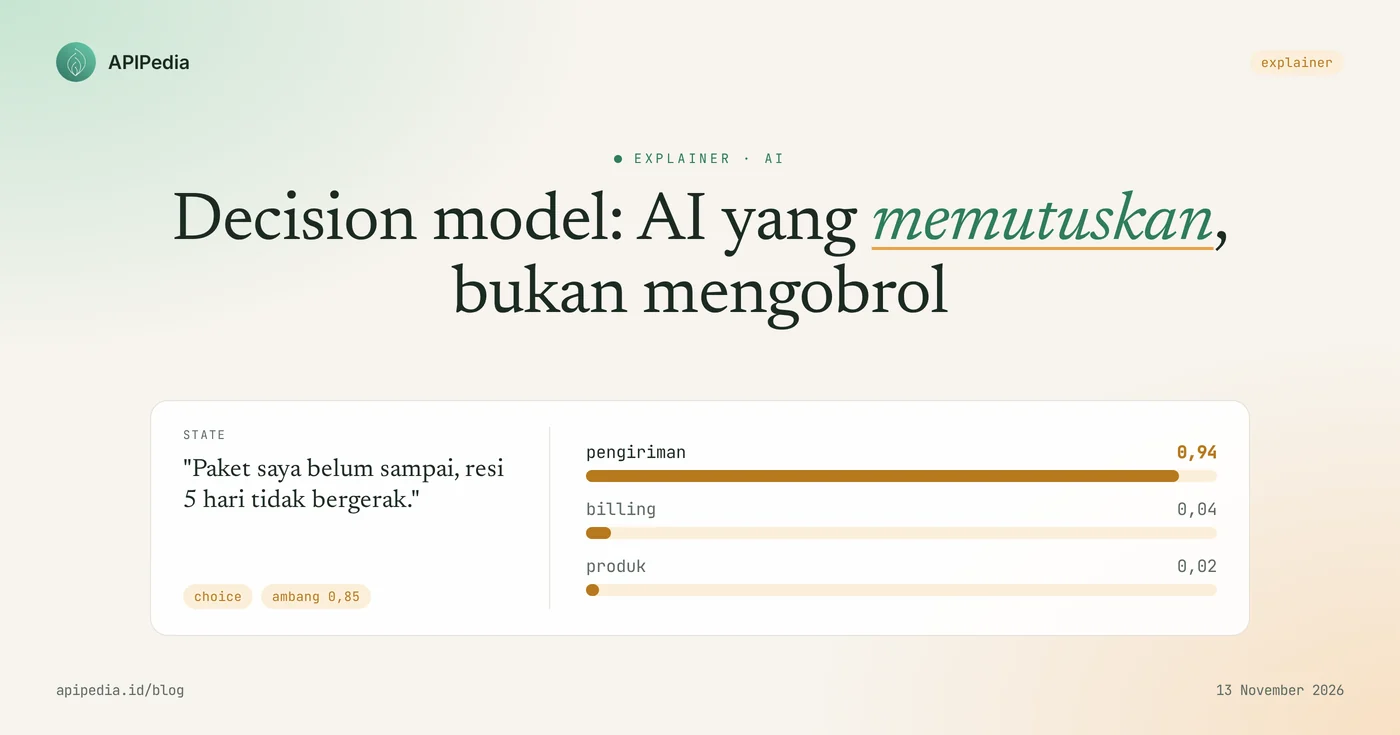
Decision model (model keputusan) adalah model AI yang menerima data dan pertanyaan dengan pilihan jawaban yang sudah ditentukan, lalu mengembalikan keputusan beserta probabilitasnya, tanpa menulis teks. Istilah ini ramai dipakai sejak TypeSafe AI merilis Jev pada September 2026. Kini sudah ada beberapa decision model lain, baik yang tertutup seperti Liquid d1 dan OpenAI Decisions, maupun yang terbuka seperti Clef 27B dari Cloudflare dan Kev 9B.
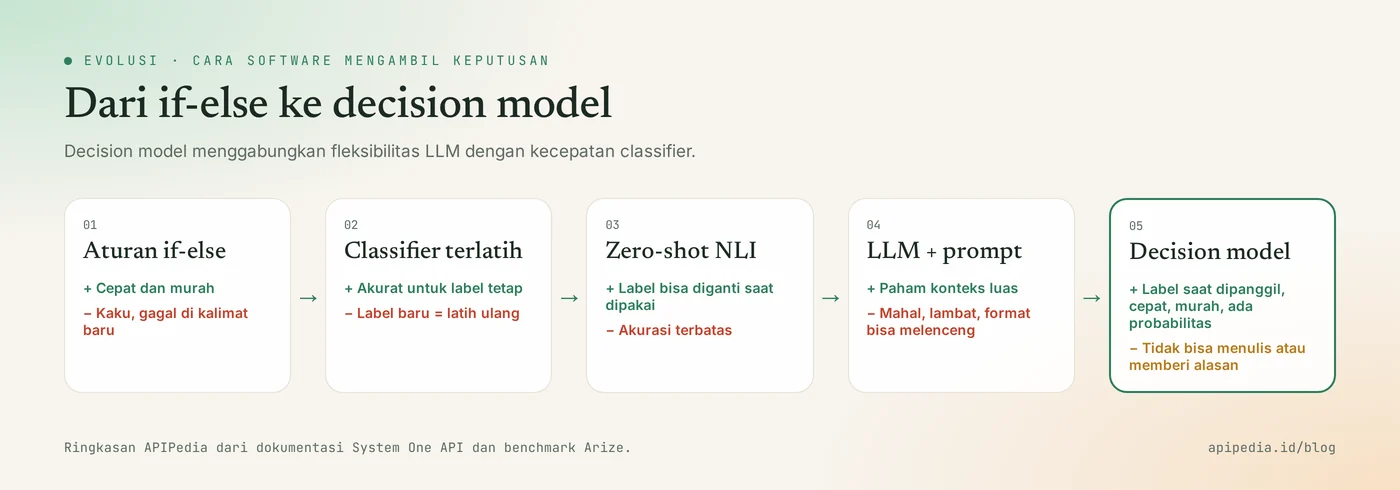
Bagi developer, model keputusan mengisi celah antara aturan if-else yang kaku dan LLM yang mahal serta lambat. Artikel ini menjelaskan cara kerja decision model, apa itu kalibrasi, bedanya dengan classifier lama, dan cara memilih modelnya.
Ringkasan cepat: decision model itu apa?
Decision model adalah "fungsi" AI: masukannya state dan pertanyaan, keluarannya jawaban bertipe yang bisa langsung dipakai kode.
| Item | Penjelasan |
|---|---|
| Input | State (teks, JSON, kadang gambar) + pertanyaan bertipe |
| Tipe jawaban | Ya/tidak (probabilitas), pilih satu dari daftar, atau skor pada skala berurutan |
| Ciri utama | Ruang jawaban tetap, output sesuai skema, ada probabilitas, idealnya terkalibrasi |
| Contoh model | Jev (TypeSafe), Liquid d1 (Liquid AI), OpenAI Decisions, Clef 27B (Cloudflare), Kev 9B, Laya |
| Tagihan umum | Per token input; untuk Jev, output gratis |
| Pemakaian | Routing, klasifikasi, moderasi, deteksi halusinasi, LLM judge, pemilihan tool agen |
Bagaimana decision model bekerja?
Model ini bekerja dengan menilai setiap opsi jawaban yang Anda berikan terhadap state, lalu memberi probabilitas pada tiap opsi. Developer tidak menulis prompt bebas, tetapi menyusun pertanyaan seperti ini:
{
  "state": "Pesanan saya belum sampai, padahal resi sudah 5 hari tidak bergerak.",
  "questions": {
    "tim": {
      "type": "choice",
      "instructions": "Tim mana yang harus menangani pesan ini?",
      "criteria": {
        "pengiriman": "Paket terlambat, hilang, atau resi tidak bergerak",
        "billing": "Tagihan, refund, atau potongan saldo",
        "produk": "Barang rusak atau tidak sesuai"
      }
    },
    "marah": { "type": "noul", "instructions": "Pelanggan terdengar kesal" }
  }
}
Hasilnya berupa angka, misalnya tim: pengiriman (0,94) dan marah: 0,72. Kode Anda yang memutuskan langkah berikutnya: kirim langsung ke tim pengiriman, beri prioritas, atau oper ke manusia bila keyakinannya rendah. Format request di atas mengikuti API System One yang dipakai Jev dan sejumlah penyedia lain.
Apa bedanya dengan classifier lama?
Classifier lama (misalnya model sentimen atau spam yang dilatih sendiri) hanya mengenal label yang dipakai saat training. Kalau Anda ingin label baru, Anda harus mengumpulkan data dan melatih ulang. Model keputusan menerima label dan definisinya saat dipanggil, jadi Anda cukup mengganti criteria untuk tugas baru. Kemampuan ini mirip classifier zero-shot berbasis NLI, tetapi model keputusan modern dilatih lebih luas dan mendukung beberapa pertanyaan sekaligus dalam satu panggilan.
Apa itu kalibrasi, dan kenapa penting?
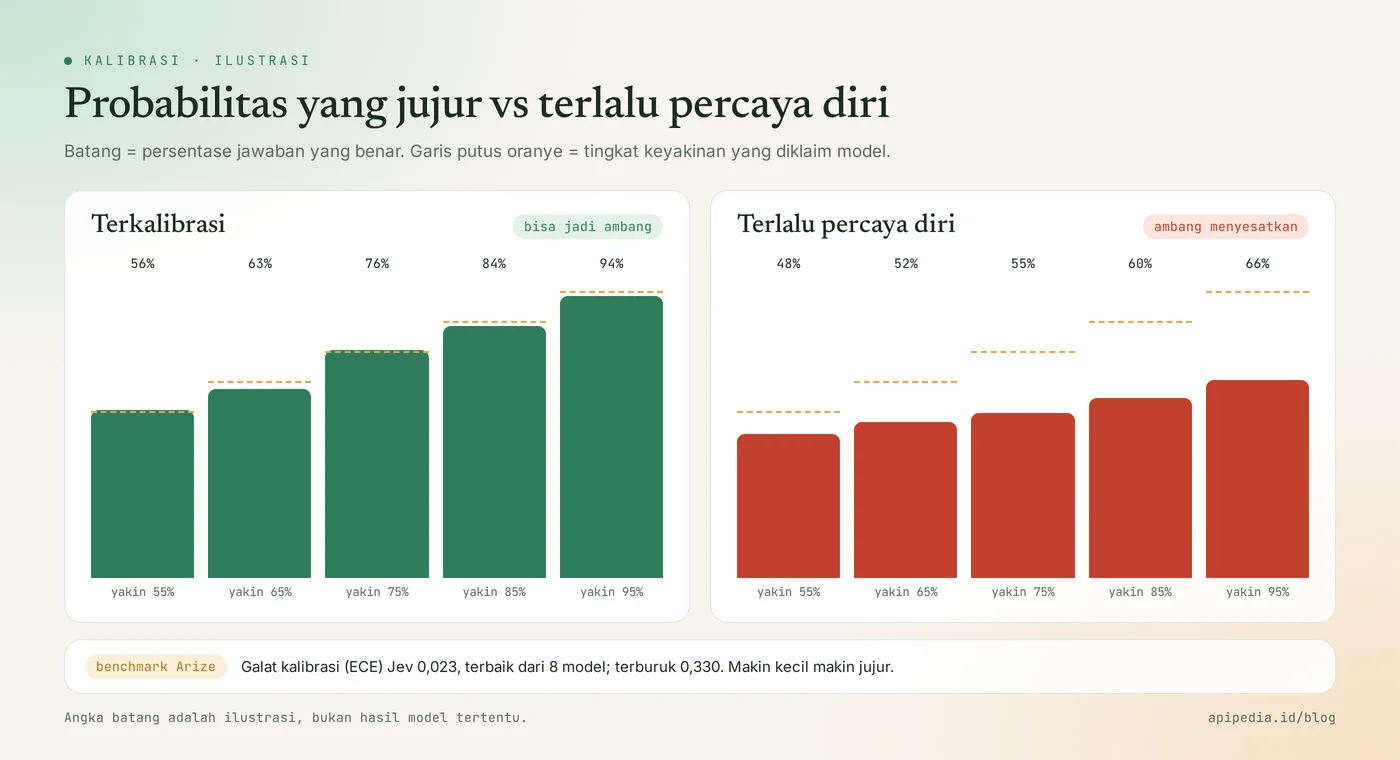
Kalibrasi penting karena menentukan apakah probabilitas model bisa dipercaya sebagai ambang otomatis. Kalibrasi adalah kesesuaian antara probabilitas yang diberikan model dan tingkat benarnya di dunia nyata. Model yang terkalibrasi baik, bila memberi keyakinan 80% pada sekumpulan jawaban, akan benar pada kira-kira 80% di antaranya. Tanpa kalibrasi, angka 0,9 bisa saja hanya benar 60% dari waktu, sehingga ambang otomatis Anda menjadi menyesatkan.
Kalibrasi biasanya diukur dengan ECE (expected calibration error): makin kecil, makin jujur probabilitasnya. Dalam benchmark Arize terhadap delapan decision model, Jev mencatat galat kalibrasi terkecil (0,023), sedangkan model terburuk mencapai 0,330. TypeSafe melatih Jev dengan metode yang mereka sebut RLCD (Reinforcement Learning for Calibrated Decisions) justru untuk mengejar sifat ini.
Cara memakai probabilitas dengan benar
- Kumpulkan 100–500 contoh berlabel dari data asli Anda, misalnya tiket yang sudah diberi tim yang benar.
- Jalankan model keputusan pada contoh itu dan simpan probabilitasnya.
- Cari ambang yang memberi akurasi cukup tinggi, misalnya 95% untuk jawaban dengan keyakinan ≥ 0,85.
- Otomatiskan hanya di atas ambang. Sisanya oper ke manusia atau LLM yang lebih besar.
- Uji ulang setiap ganti versi model atau ganti kata-kata pertanyaan.
Langkah kelima penting. Arize menemukan bahwa sebagian model hasilnya terbalik saat pertanyaan yang sama ditulis dengan kalimat berbeda, jadi uji beberapa versi kalimat sebelum dipakai.
Decision model apa saja yang sudah ada?
Per November 2026 sudah ada decision model tertutup (diakses lewat API) dan terbuka (bisa dijalankan sendiri). Daftar di bawah mengikuti benchmark Arize (7 Oktober 2026):
| Model | Pembuat | Akses | Harga input per 1 juta token |
|---|---|---|---|
| Jev 1.13 | TypeSafe AI | Tertutup, API | $0,042 |
| Liquid d1 | Liquid AI | Tertutup, API | $0,04 |
| OpenAI Decisions | OpenAI | Tertutup, API | $0,10 |
| Clef 27B | Cloudflare | Terbuka (Apache 2.0) | $0,24 lewat API, atau self-host |
| Kev 9B | Jared Palmer | Terbuka | Gratis self-host |
| Jeeves 9B | PostHog | Terbuka | Gratis self-host |
| Strands Decider 2B | AWS | Terbuka | Gratis self-host |
| Laya multilingual | Convai Innovations | Terbuka (Apache 2.0) | Gratis self-host |
Di benchmark itu, model teratas berselisih tipis. Pada deteksi halusinasi, Jev, Clef, dan Liquid berbeda sekitar satu poin persen, sehingga Arize menyarankan memilih dulu berdasarkan cara deploy (API atau self-host), baru membandingkan latensi dan biaya.
Kapan memakai decision model?
Decision model paling tepat dipakai kalau keputusannya berulang, pilihan jawabannya bisa ditulis di awal, dan Anda butuh hasil cepat dan murah. Tetap pakai LLM generatif kalau Anda butuh teks, penjelasan, atau penalaran panjang. Untuk aplikasi di Indonesia, uji juga dengan teks berbahasa Indonesia campur bahasa daerah atau singkatan chat, karena sebagian besar benchmark publik memakai bahasa Inggris.
Decision model adalah wujud nyata dari konsep model System One. Contoh paling dikenal adalah Jev dari TypeSafe AI, dan perbandingannya dengan chatbot ada di artikel perbedaan Jev dan LLM biasa.
Pertanyaan yang sering diajukan
Apakah decision model sama dengan classifier?
Model keputusan adalah bentuk classifier yang lebih fleksibel. Label dan definisinya diberikan saat pemanggilan, bukan saat training, dan satu panggilan bisa menjawab beberapa pertanyaan sekaligus.
Apakah decision model bisa membaca gambar?
Sebagian bisa. Beberapa model terbuka menerima gambar, dan Jev punya dukungan gambar yang masih eksperimental. Cek dokumentasi tiap model sebelum dipakai.
Berapa biaya satu keputusan?
Tergantung panjang input. Di benchmark Arize, biaya per 1.000 keputusan deteksi halusinasi sekitar $0,034 untuk Liquid d1 dan $0,045 untuk Jev. Sebagai pembanding, LLM judge yang mereka hitung memakan $14,30 per 1.000 penilaian.
Apakah angka probabilitas bisa langsung dipercaya?
Belum tentu. Kalibrasi berbeda antar model dan antar jenis tugas. Selalu ukur di data berlabel milik Anda sebelum menentukan ambang otomatis.
Sumber
Topik: #ai #decision model #model keputusan #kalibrasi #jev #explainer
Tentang penulis
Tim APIPedia — Tim Engineering APIPedia
Tim engineering di balik APIPedia yang membangun dan memelihara API data Indonesia - ongkir, OCR KTP, data wilayah, BMKG, hingga server MCP - dan menulis panduan integrasinya dari pengalaman langsung.