Perbedaan Jev dan LLM Biasa: Beda Tugas, Beda Tagihan
Oleh Tim APIPedia, Tim Engineering APIPedia · Terbit · 6 menit baca
Jev memilih jawaban dengan probabilitas, LLM menulis teks. Bandingkan output, biaya, kecepatan, akurasi, dan kapan memakai masing-masing.
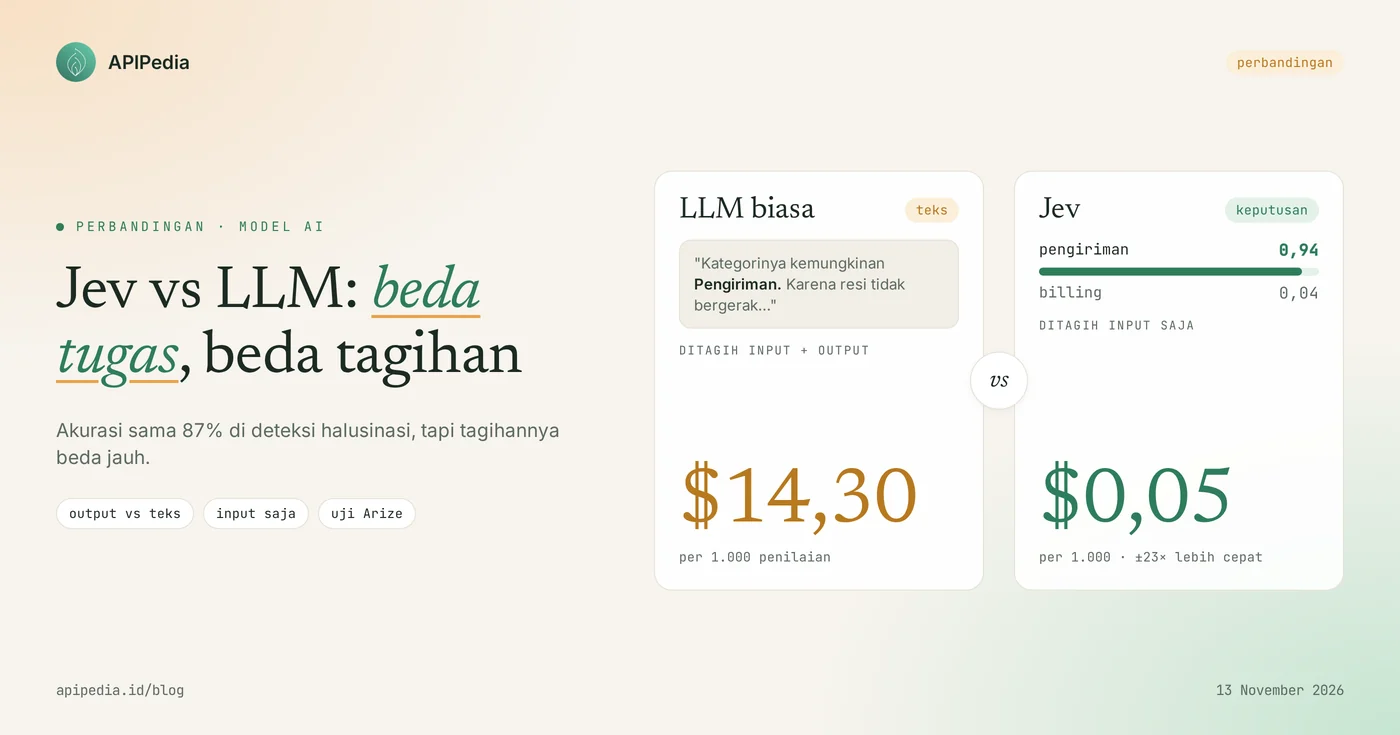
Bedanya: LLM biasa seperti ChatGPT atau Claude menulis jawaban kata demi kata, sedangkan Jev hanya memilih jawaban dari daftar yang sudah Anda tentukan dan memberi probabilitasnya. Karena itu Jev jauh lebih cepat dan murah untuk tugas keputusan, tetapi tidak bisa menulis, menjelaskan, atau bernalar panjang. Keduanya bukan pengganti satu sama lain, melainkan alat untuk pekerjaan yang berbeda.
Banyak tim memakai LLM untuk semua hal, termasuk tugas sederhana seperti "tiket ini masuk kategori apa?". Artikel ini membandingkan Jev dan LLM dari sisi output, biaya, kecepatan, akurasi, dan jenis kesalahan, lalu membantu Anda memilih kapan memakai yang mana.
Ringkasan cepat: Jev vs LLM biasa
Perbedaan Jev dan LLM paling terasa di bentuk output, cara tagihan, dan jenis kesalahannya.
| Aspek | Jev (model System One) | LLM biasa (ChatGPT, Claude, Gemini, dll.) |
|---|---|---|
| Output | Keputusan bertipe + probabilitas | Teks bebas, bisa juga JSON lewat structured output |
| Cara menghasilkan | Semua pertanyaan dijawab paralel dalam satu proses | Token demi token, berurutan |
| Tagihan | Hanya input ($0,042 per 1 juta token), output gratis | Input + output, output biasanya beberapa kali lebih mahal |
| Latensi | 70–500 ms (klaim TypeSafe) | Detik sampai menit, apalagi dengan mode reasoning |
| Jenis kesalahan | Memilih opsi yang salah dengan yakin | Mengarang isi, format tidak konsisten, atau label di luar daftar |
| Alasan | Tidak ada, hanya angka | Bisa menjelaskan alasannya |
| Cocok untuk | Routing, klasifikasi, moderasi, penilaian massal, gerbang otomatis | Menulis, merangkum, membalas pelanggan, coding, analisis panjang |
Apa beda output Jev dan LLM?
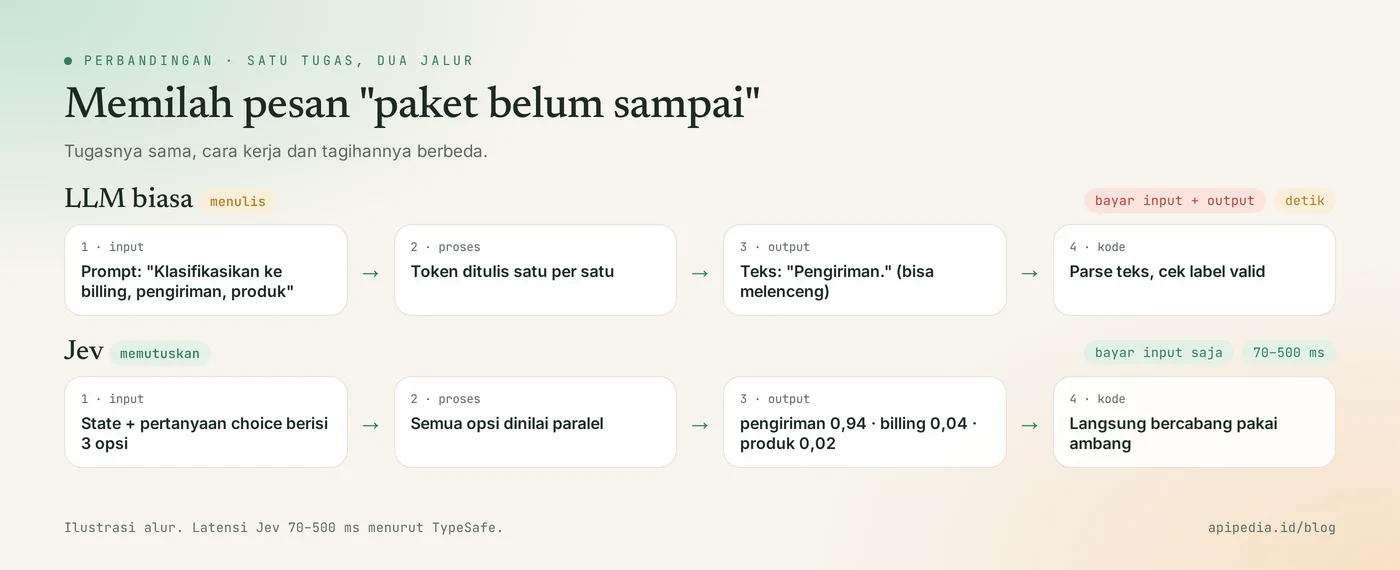
Output Jev selalu berupa nilai yang sudah Anda definisikan, sedangkan output LLM adalah teks yang harus dibaca atau di-parse lagi. Misalnya Anda ingin memilah pesan "Paket saya belum sampai, resi 5 hari tidak bergerak".
Dengan LLM, Anda menulis prompt "Klasifikasikan pesan ini ke billing, pengiriman, atau produk. Jawab satu kata." Biasanya jawabannya benar, tetapi sesekali LLM menulis "Pengiriman." dengan titik, "pengiriman/logistik", atau menambah kalimat penjelasan. Fitur structured output mengurangi masalah ini, tetapi Anda tetap membayar token output dan menunggu proses pembuatan teks.
Dengan Jev, Anda mengirim pertanyaan bertipe choice berisi tiga opsi. Jawabannya selalu salah satu dari tiga label itu, lengkap dengan probabilitas tiap opsi, misalnya pengiriman: 0,94. Ada satu perbedaan halus lagi: menurut dokumentasi Vercel, adapter structured output LLM biasanya menggabungkan semua pertanyaan dalam satu prompt, sedangkan Jev menilai setiap pertanyaan secara terpisah. Bentuk hasil yang sama belum tentu berarti perilaku penilaiannya sama.
Berapa selisih biaya dan kecepatannya?
Selisih biaya dan kecepatannya besar. Untuk tugas keputusan, Jev umumnya puluhan sampai ratusan kali lebih murah dari LLM. Penyebabnya struktural: Jev hanya menagih input, sedangkan LLM juga menagih output dan, pada model reasoning, token berpikir. Beberapa hasil uji pihak ketiga:
- Arize, deteksi halusinasi: setelah ambang Jev disetel di 0,80, Jev dan Claude Opus 5 sama-sama mencapai akurasi 87%. Biayanya $0,05 per 1.000 penilaian untuk Jev, dibanding $14,30 untuk Opus 5, dengan kecepatan sekitar 23 kali lipat.
- Braintrust, ketepatan jawaban: Jev mencapai 78,1%, sedangkan GPT-5.6 Luna dengan reasoning mencapai 88,6%. GPT-5.6 Luna lebih akurat, tetapi biayanya 13,2 kali lebih mahal dan waktunya 23,3 kali lebih lama.
- Klaim TypeSafe: 20–200 kali lebih cepat dan 40–400 kali lebih murah untuk tugas berbentuk keputusan, diukur sendiri oleh TypeSafe.
Pola ini konsisten: Jev menang telak di biaya dan kecepatan. Soal akurasi, Jev bisa setara pada sebagian tugas tetapi tertinggal pada tugas lain, terutama yang butuh penalaran lebih dalam.
Contoh hitung biaya untuk aplikasi Anda
Misalkan toko online Anda memilah 100.000 pesan pelanggan per bulan, masing-masing sekitar 300 token. Dengan Jev, total inputnya 30 juta token × $0,042 per 1 juta = sekitar $1,26 per bulan, tanpa biaya output. Untuk LLM, hitung dengan tarif input dan output model yang Anda pakai, plus token output untuk setiap jawaban. Rumus dan contoh hitung tokennya ada di artikel token AI seperti pulsa.
Kesalahan apa yang biasa terjadi di masing-masing?
Kesalahan yang biasa terjadi di LLM adalah halusinasi, sedangkan di Jev adalah salah pilih dengan yakin. LLM bisa berhalusinasi: mengarang fakta, membuat label baru, atau memanggil tool yang salah. Jev tidak bisa mengarang di luar daftar jawaban, tetapi tetap bisa memilih jawaban yang keliru dengan yakin. Vercel memberi contoh tiket yang diarahkan ke tim yang terdengar masuk akal, padahal tim yang salah.
Perbedaan pentingnya ada di probabilitas. Jev dilatih supaya probabilitasnya terkalibrasi, sehingga Anda bisa memakai angka itu sebagai gerbang: di atas ambang dijalankan otomatis, di bawah ambang dioper ke manusia atau LLM. LLM juga bisa diminta menyebut "tingkat keyakinan", tetapi angka yang ditulis LLM itu bagian dari teks, bukan probabilitas yang terukur.
Kapan memakai Jev, kapan memakai LLM?
Gunakan Jev untuk keputusan berulang yang jawabannya bisa ditentukan sebelumnya, dan gunakan LLM saat Anda butuh teks atau penalaran.
| Kebutuhan | Pilihan |
|---|---|
| Memilah tiket, email, atau chat ke tim yang tepat | Jev |
| Menandai komentar atau ulasan yang perlu dimoderasi | Jev |
| Menentukan prompt dijawab model kecil atau model besar | Jev |
| Menilai ribuan jawaban AI (LLM judge) dengan biaya rendah | Jev, dengan ambang yang sudah diuji |
| Membalas pelanggan dengan bahasa yang ramah | LLM |
| Merangkum dokumen atau rapat | LLM |
| Menulis atau memperbaiki kode | LLM |
| Keputusan rumit yang butuh alasan tertulis | LLM, atau Jev untuk saringan awal lalu LLM |
Pola terbaik: gabungkan keduanya
Pola yang paling hemat adalah cascade: semua permintaan dinilai Jev dulu, yang keyakinannya tinggi langsung diproses, dan hanya sisanya yang diteruskan ke LLM besar. Satu studi independen yang dirangkum Amplitude menemukan cascade dengan ambang 0,80 bisa menyamai akurasi model frontier dengan sekitar seperempat biaya dan setengah latensi. Hasil ini perlu diuji ulang di data Anda, tetapi polanya layak dicoba.
Pertanyaan yang sering diajukan
Apakah Jev lebih pintar dari ChatGPT?
Tidak bisa dibandingkan langsung. Jev hanya mengerjakan keputusan bertipe, dan untuk sebagian tugas itu akurasinya setara LLM besar dengan biaya jauh lebih rendah. Untuk menulis, menjelaskan, atau bernalar panjang, LLM jelas lebih unggul karena Jev memang tidak bisa melakukannya.
Apakah structured output LLM sama dengan Jev?
Mirip di bentuk hasil, berbeda di cara kerja. Structured output memaksa LLM menulis JSON sesuai skema, tetapi LLM tetap membuat token satu per satu dan menagih output. Jev memberi probabilitas untuk setiap opsi dalam satu proses paralel.
Apakah saya perlu mengganti LLM dengan Jev?
Tidak perlu mengganti. Pindahkan hanya bagian keputusan, seperti klasifikasi dan routing, ke Jev. Biarkan LLM mengerjakan bagian yang memang butuh teks.
Bagaimana cara mencoba Jev?
Buat kunci API di konsol TypeSafe atau lewat mitra seperti DigitalOcean dan Vercel, lalu kirim request ke endpoint /v1/systemone. Contoh lengkapnya ada di panduan Jev di cloud, Jev lokal, dan Qev.
Belum kenal Jev? Mulai dari apa itu Jev, lalu pahami konsepnya di model System One dan decision model.
Sumber
- Arize: Jev vs. LLM-as-a-Judge, accuracy and cost benchmarks
- Braintrust: When Jev holds up as a judge
- Vercel: What is Jev, TypeSafe AI's System One model?
- Amplitude: An analysis of Jev, faster and cheaper, but watch the accuracy
- TestingCatalog: TypeSafe AI launches Jev for structured AI decisions
- The New Stack: TypeSafe launched Jev, a System One model
Topik: #ai #jev #llm #perbandingan #model keputusan #biaya ai
Tentang penulis
Tim APIPedia — Tim Engineering APIPedia
Tim engineering di balik APIPedia yang membangun dan memelihara API data Indonesia - ongkir, OCR KTP, data wilayah, BMKG, hingga server MCP - dan menulis panduan integrasinya dari pengalaman langsung.