OCR Itu Seperti Juru Ketik: Cara Kerja Mesin Membaca Teks dari Foto, Arti Skor Confidence, dan Kenapa Hasilnya Bisa Salah
Oleh Tim APIPedia, Tim Engineering APIPedia · Terbit · 10 menit baca
OCR mengubah foto dokumen menjadi teks. Ini cara kerjanya, arti skor confidence, hasil uji enam kondisi foto, dan tips agar akurat.
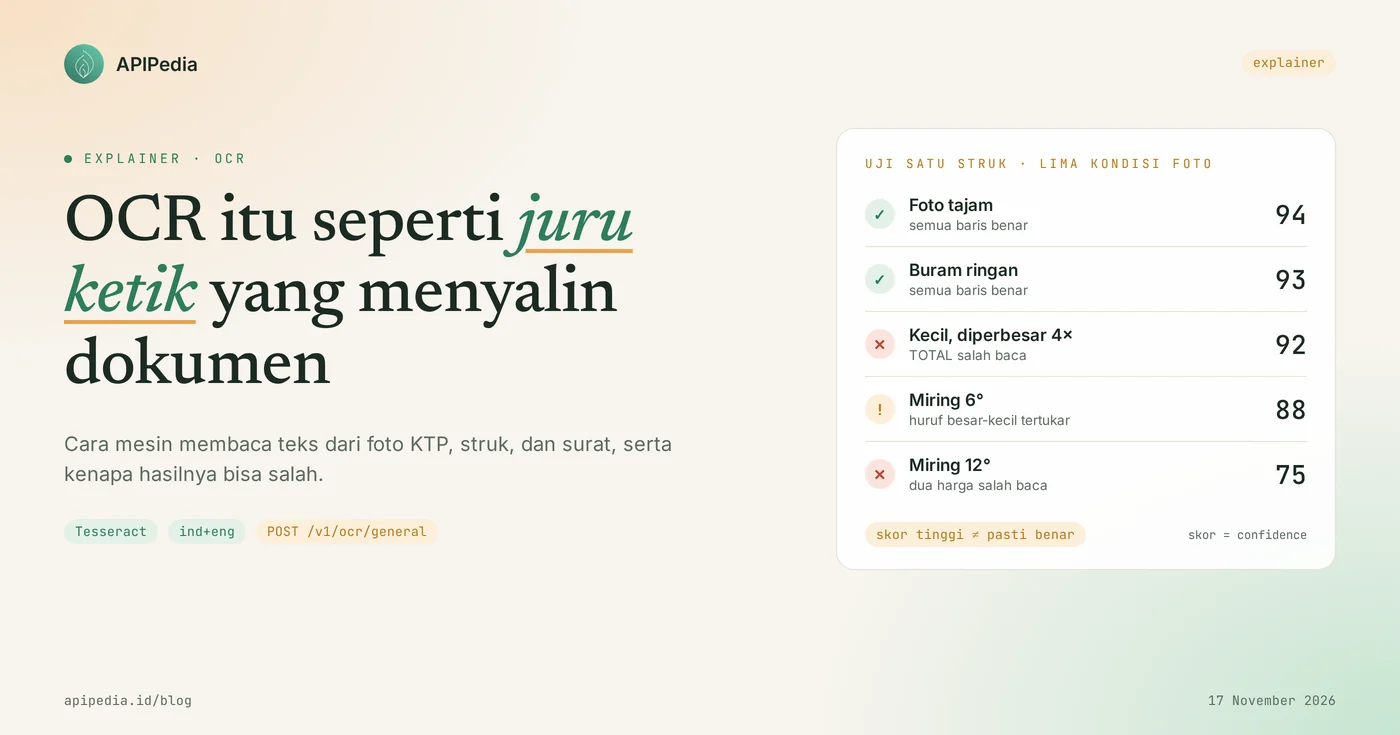
OCR (Optical Character Recognition) adalah teknologi yang mengubah teks di dalam gambar, misalnya foto KTP, struk belanja, atau surat hasil pindai, menjadi teks digital yang bisa disalin, dicari, dan diolah program. Cara paling gampang membayangkannya: OCR itu seperti juru ketik di depan kantor kelurahan. Ia melihat lembar yang Anda sodorkan, mengeja huruf demi huruf, lalu mengetik ulang isinya. Kalau fotokopinya buram atau miring, ia bisa salah ketik.
Bagi developer dan pemilik bisnis, OCR penting karena banyak data masih datang sebagai foto: KTP pelanggan, struk reimburse, surat jalan. Artikel ini membahas cara kerja OCR langkah demi langkah, arti skor confidence, hasil uji nyata kami pada enam kondisi foto, hal yang sering disalahpahami, dan tips agar hasil baca lebih akurat.
Ringkasan cepat: istilah apa saja yang perlu Anda tahu?
OCR membaca bentuk huruf di gambar dan mengeluarkan teks beserta skor keyakinan, tanpa memahami arti dokumennya. Tabel berikut merangkum istilah yang akan sering Anda temui.
| Istilah | Artinya |
|---|---|
| OCR | Optical Character Recognition, pengenalan karakter dari gambar menjadi teks |
| Mesin OCR (engine) | Program yang melakukan pembacaan. Contohnya Tesseract, mesin open source berlisensi Apache 2.0 |
| Binarisasi | Mengubah gambar menjadi hitam-putih supaya huruf terpisah dari latar |
| Analisis tata letak | Mencari blok teks, baris, dan kata sebelum huruf dikenali |
| LSTM | Jenis jaringan saraf yang dipakai Tesseract sejak versi 4.0 untuk mengenali satu baris teks sekaligus |
| Data bahasa | Model per bahasa. ind+eng berarti bahasa Indonesia dan Inggris dipakai bersamaan |
confidence | Skor keyakinan mesin, 0 sampai 100. Ini ukuran yakin, bukan ukuran benar |
| OCR terstruktur | OCR yang hasilnya sudah dipilah per field, misalnya NIK, nama, dan alamat pada KTP |
Apa itu OCR?
OCR adalah proses mengenali huruf dan angka pada gambar lalu menuliskannya ulang sebagai teks. Bagi komputer, foto struk hanyalah kumpulan piksel berwarna. Komputer tidak tahu bahwa deretan piksel gelap itu berbunyi "TOTAL 120.000" sampai ada mesin OCR yang membacanya.
Kembali ke juru ketik. Ia tidak perlu paham isi surat Anda. Tugasnya hanya menyalin apa yang terlihat. Karena itu ia bisa menyalin surat berbahasa asing sekalipun, tetapi ia juga tidak akan sadar bila angka yang diketiknya tidak masuk akal. Mesin OCR punya sifat yang sama: rajin menyalin, tidak memeriksa makna.
Di kehidupan sehari-hari, OCR bekerja saat Anda memindai dokumen menjadi PDF yang bisa dicari, saat aplikasi mengisi formulir dari foto KTP, dan saat kamera ponsel menyalin teks dari papan pengumuman.
Bagaimana cara kerja OCR langkah demi langkah?
OCR bekerja dalam lima langkah: gambar diterima, dirapikan menjadi hitam-putih, baris teksnya dicari, hurufnya dikenali, lalu teks dan skor keyakinan dikeluarkan. Urutan ini mengikuti cara kerja Tesseract, mesin yang juga dipakai produk OCR General di APIPedia.
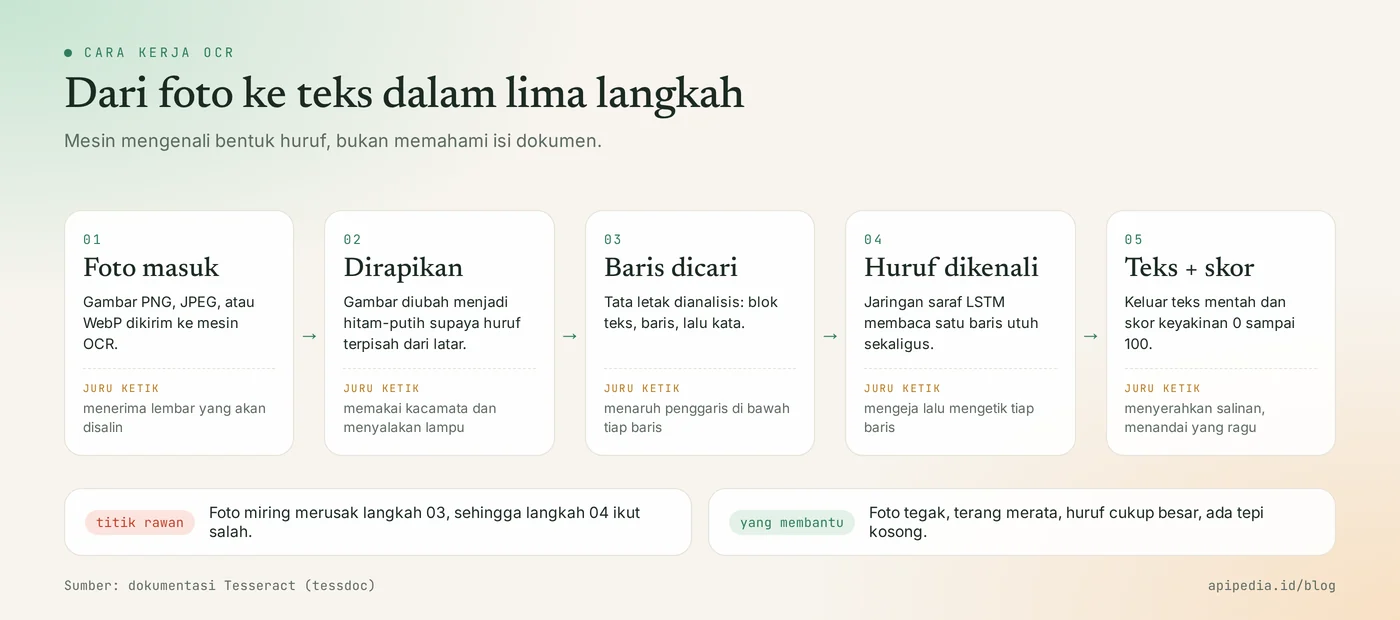
Langkah 1 dan 2: gambar diterima lalu dirapikan
Mesin lebih dulu mengubah gambar menjadi hitam-putih, proses yang disebut binarisasi. Dokumentasi Tesseract menyebut mesin ini melakukannya secara internal dengan algoritma Otsu, dan sejak versi 5.0.0 tersedia dua metode tambahan, Adaptive Otsu dan Sauvola. Bila latar foto gelap sebelah, misalnya karena bayangan tangan, hasil binarisasi bisa kurang baik dan sebagian huruf ikut hilang.
Langkah 3: baris teks dicari
Sebelum membaca huruf, mesin menentukan di mana letak blok teks, baris, dan kata. Juru ketik melakukan hal serupa dengan menaruh penggaris di bawah baris yang sedang disalin. Di sinilah foto miring menjadi masalah: dokumentasi Tesseract menyatakan kualitas pemisahan baris turun signifikan bila halaman terlalu miring.
Langkah 4: huruf dikenali
Sejak versi 4.0, Tesseract memakai jaringan saraf LSTM yang dikonfigurasi sebagai pengenal baris teks. Artinya mesin membaca satu baris utuh sebagai urutan, bukan mencocokkan huruf satu per satu dengan cetakan. Konteks di sekitar huruf ikut membantu, sama seperti juru ketik yang bisa menebak huruf pudar dari kata di sekelilingnya.
Langkah 5: teks dan skor keyakinan dikeluarkan
Hasil akhirnya adalah teks mentah dan skor keyakinan. Skor itu menggambarkan seberapa yakin mesin terhadap bacaannya sendiri. Juru ketik yang ragu biasanya memberi tanda tanya kecil di pinggir kertas, dan skor confidence berperan seperti tanda itu.
Seperti apa contoh nyata hasil OCR?
Hasil OCR berbentuk teks apa adanya, baris demi baris, ditambah satu angka keyakinan. Kami membuat gambar struk fiktif berukuran 640×360 piksel, lalu mengirimnya ke POST /v1/ocr/general pada 17 November 2026.
jq -n --arg img "$(base64 -w0 struk.png)" '{image_base64: $img}' \
  | curl -s -X POST https://api.apipedia.id/v1/ocr/general \
      -H "Authorization: Bearer apk_xxx" \
      -H "Content-Type: application/json" \
      -d @-
Respons nyata untuk foto yang tajam:
{
  "is_success": true,
  "message": "Text extracted from image",
  "data": {
    "text": "TOKO SUMBER REJEKI\n\nJl. Melati No. 12, Sleman\nBeras 5 kg 68.500\nMinyak 2 L 34.000\nGula 1 kg 17.500\nTOTAL 120.000\nTerima kasih",
    "confidence": 94,
    "lang": "ind+eng"
  }
}
Semua baris terbaca benar dengan skor 94. Nama field body bisa Anda cek ulang di spesifikasi OpenAPI produk OCR General pada konsol. Kunci apk_xxx hanyalah contoh, dan cara menjaganya ada di artikel API key itu seperti kartu akses kos.
Apa yang terjadi kalau fotonya buram, kecil, atau miring?
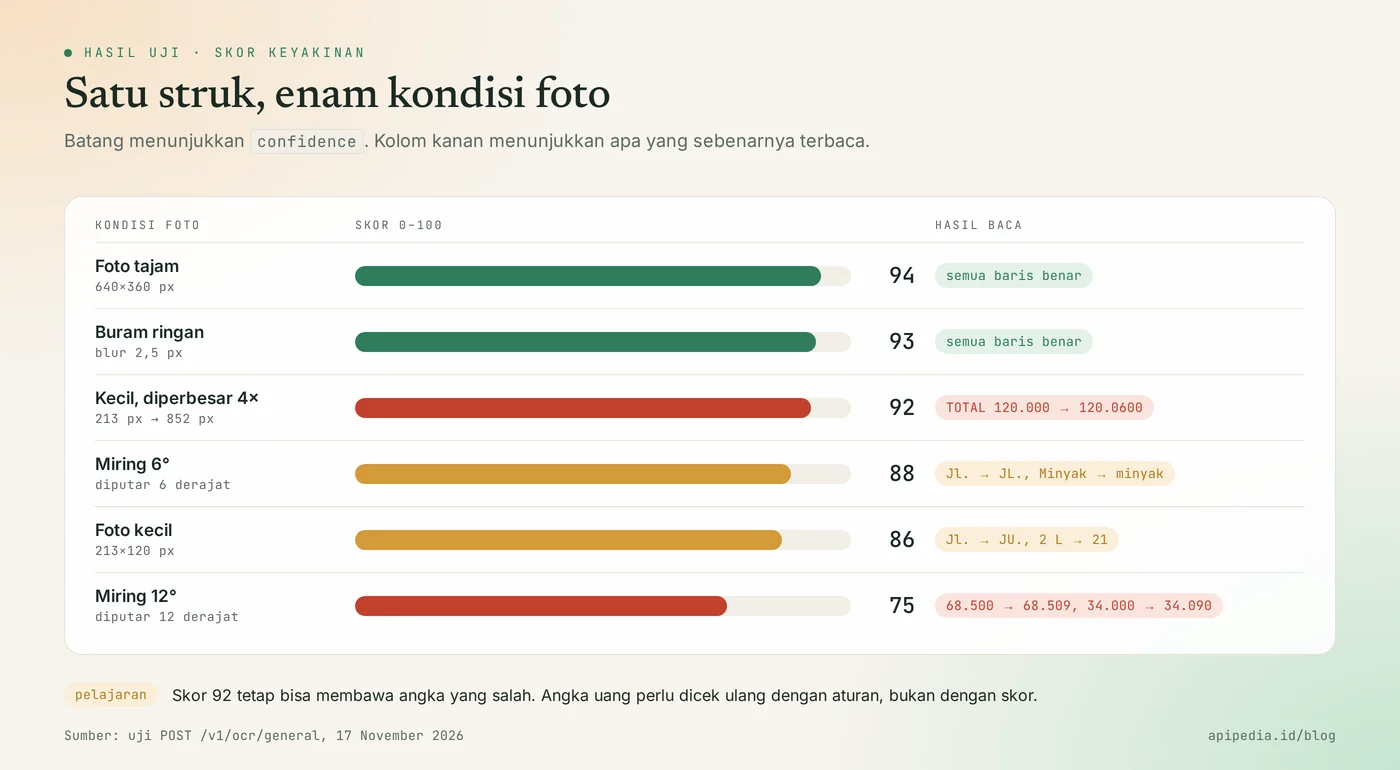
Kualitas foto langsung mengubah hasil baca, dan yang paling merusak dalam uji kami adalah kemiringan serta ukuran huruf yang terlalu kecil. Kami mengirim struk yang sama dalam enam kondisi ke endpoint yang sama. Hasilnya seperti berikut.
| Kondisi foto | confidence | Yang terbaca |
|---|---|---|
| Tajam, 640×360 piksel | 94 | Semua baris benar |
| Buram ringan (blur 2,5 piksel) | 93 | Semua baris benar |
| Kecil lalu diperbesar 4 kali | 92 | TOTAL 120.0600, seharusnya 120.000 |
| Miring 6 derajat | 88 | JL. dan minyak, harga tetap benar |
| Kecil, 213×120 piksel | 86 | JU. dan Minyak 21 |
| Miring 12 derajat | 75 | 68.509 dan 34.090, dua harga salah |
Ada dua pelajaran dari tabel ini. Pertama, buram ringan ternyata masih aman, sedangkan miring 12 derajat sudah mengubah dua harga. Kedua, skor 92 pada foto yang diperbesar tetap membawa total yang salah. Uji ini memakai satu gambar buatan dengan huruf cetak yang rapi, jadi anggap angkanya sebagai gambaran, bukan jaminan untuk foto Anda.
Apa saja yang sering disalahpahami tentang OCR?
Kesalahpahaman paling umum adalah menganggap skor keyakinan tinggi berarti hasilnya pasti benar. Berikut lima anggapan yang perlu diluruskan.
- "Skor tinggi berarti benar." Skor mengukur keyakinan mesin, bukan kebenaran. Pada uji di atas, skor 92 membawa total yang keliru.
- "OCR memahami isi dokumen." OCR hanya menyalin bentuk huruf. Ia tidak tahu bahwa 68.509 bukan harga beras yang wajar, atau bahwa jumlah item tidak sama dengan total.
- "OCR bisa memastikan dokumen asli." OCR membaca apa yang tertulis, termasuk pada dokumen palsu. Hasil baca KTP bukan verifikasi identitas ke Dukcapil.
- "Memperbesar foto kecil memulihkan detailnya." Memperbesar hanya menambah piksel, bukan informasi. Hasil kami membaik di beberapa baris, tetapi total justru salah.
- "OCR dan AI vision itu sama." OCR klasik menyalin karakter. Model vision bisa membaca foto yang lebih sulit dan menafsirkan isinya, tetapi biayanya dihitung per token dan ia bisa mengarang teks yang tidak ada. Dasarnya ada di artikel token AI itu seperti pulsa.
Bagaimana cara memotret agar hasil OCR lebih akurat?
Foto yang tegak, terang merata, dan berhuruf cukup besar memberi hasil paling akurat. Tips berikut dirangkum dari panduan kualitas gambar di dokumentasi Tesseract dan dari hasil uji kami.
- Luruskan dokumen. Sejajarkan tepi dokumen dengan tepi layar kamera. Kemiringan adalah perusak terbesar di uji kami.
- Dekatkan kamera. Dokumen sebaiknya memenuhi sebagian besar bingkai. Untuk hasil pindai, dokumentasi Tesseract menyarankan minimal 300 dpi.
- Ratakan cahaya. Hindari bayangan tangan dan pantulan lampu, terutama pada kartu berlaminasi seperti KTP.
- Sisakan tepi kosong. Teks yang menempel ke tepi gambar lebih sulit dibaca. Tepi yang terlalu lebar juga tidak membantu.
- Pakai teks gelap di latar terang. Tesseract versi 4 ke atas mengharapkan kondisi ini.
- Kirim berkas aslinya. Tangkapan layar dari aplikasi chat biasanya sudah dikecilkan dan dikompres.
- Waspadai tabel. Dokumentasi Tesseract mengakui mesin ini kesulitan membaca data di dalam tabel tanpa pengolahan tata letak tambahan.
Bagaimana cara memeriksa hasil OCR di aplikasi?
Periksa hasil OCR dengan aturan yang Anda ketahui tentang dokumennya, bukan hanya dengan skor. Untuk struk, aturannya sederhana: format angka harus wajar dan jumlah item harus sama dengan total. Kode berikut sudah kami jalankan terhadap tiga respons nyata dari uji di atas.
import re


def angka_rupiah(s):
    """'68.500' -> 68500. Format lain (mis. '120.0600') -> None."""
    return int(s.replace(".", "")) if re.fullmatch(r"\d{1,3}(\.\d{3})*", s) else None


def cek_struk(text):
    item, total = [], None
    for baris in text.splitlines():
        kata = baris.split()
        if len(kata) < 2 or not re.fullmatch(r"[\d.]+", kata[-1]):
            continue  # bukan baris harga
        nilai = angka_rupiah(kata[-1])
        if nilai is None:
            return {"ok": False, "alasan": f"Format angka tidak wajar: {kata[-1]}"}
        if kata[0].upper() == "TOTAL":
            total = nilai
        else:
            item.append(nilai)
    if total is None:
        return {"ok": False, "alasan": "Baris TOTAL tidak ditemukan"}
    if sum(item) != total:
        return {"ok": False, "alasan": f"Jumlah item {sum(item)} tidak sama dengan total {total}"}
    return {"ok": True, "total": total}
Hasilnya saat dijalankan:
tajam -> {'ok': True, 'total': 120000}
diperbesar 4x -> {'ok': False, 'alasan': 'Format angka tidak wajar: 120.0600'}
miring 12 -> {'ok': False, 'alasan': 'Jumlah item 103099 tidak sama dengan total 120000'}
Dua foto bermasalah tertangkap tanpa melihat skor sama sekali. Prinsip yang sama berlaku untuk dokumen lain: NIK harus 16 digit dengan struktur yang benar, tanggal harus tanggal yang ada, dan nomor rekening harus berupa angka. Bila pemeriksaan gagal, minta pengguna memotret ulang atau arahkan ke pengecekan manual.
Layanan OCR apa saja yang tersedia di APIPedia?
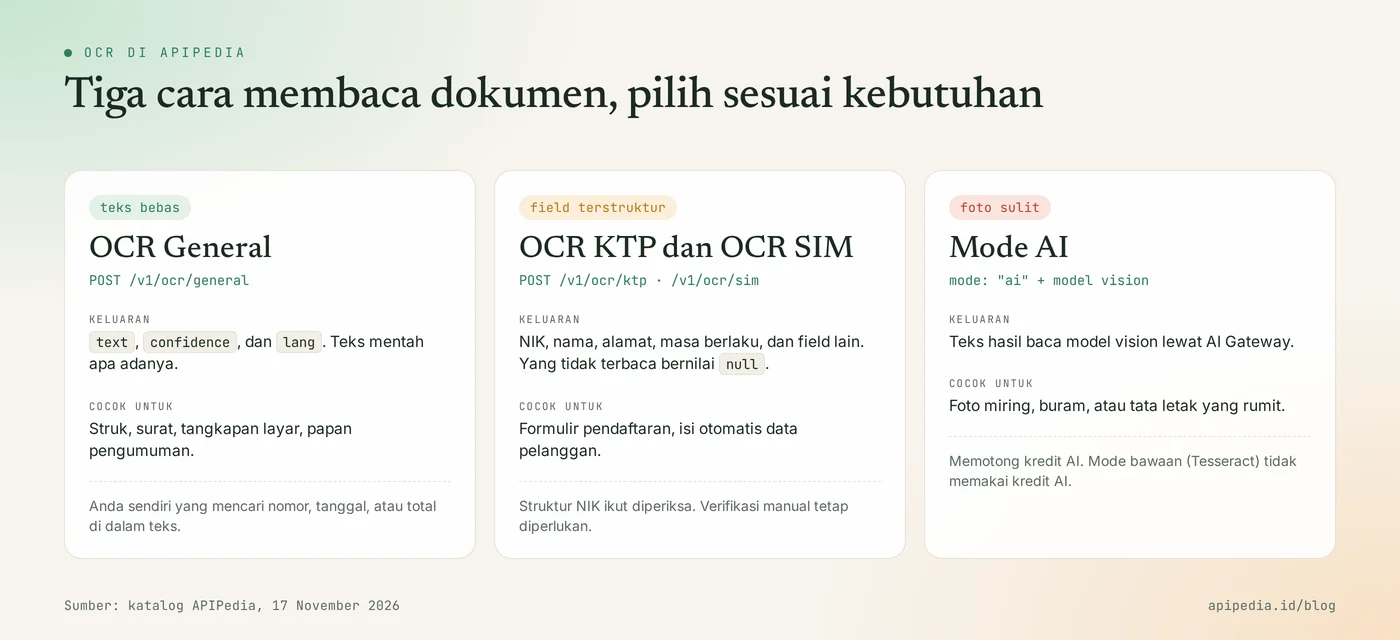
APIPedia menyediakan tiga produk OCR di katalognya: OCR General untuk teks bebas, serta OCR KTP dan OCR SIM untuk hasil yang sudah dipilah per field. OCR General juga punya mode AI untuk foto yang sulit.
- OCR General memakai Tesseract dengan data bahasa
ind+engyang berjalan sebagai WebAssembly di server. Masukannya gambar PNG, JPEG, atau WebP dalam base64. Berkas PDF belum didukung. - OCR KTP membaca foto KTP lalu menguraikan NIK, nama, tempat dan tanggal lahir, alamat, dan field lain. Field yang tidak terbaca dikembalikan
null, dan struktur NIK ikut diperiksa. - OCR SIM menguraikan nomor SIM, nama, alamat, golongan, dan masa berlaku dengan cara yang sama.
- Mode AI pada OCR General (
mode: "ai"dengan fieldmodel) memakai model vision lewat AI Gateway. Mode ini memotong kredit AI, sedangkan mode bawaan tidak.
Ketiganya tercatat di tier Free pada katalog, dan setiap panggilan tetap dihitung ke kuota request akun. Asisten AI juga bisa memakainya lewat tool ocr_general, ocr_ktp, dan ocr_sim di server MCP APIPedia.
Pertanyaan yang sering diajukan
Apa kepanjangan OCR?
OCR adalah singkatan dari Optical Character Recognition, yaitu pengenalan karakter secara optik. Teknologi ini mengubah teks pada gambar menjadi teks digital.
Apakah OCR bisa membaca tulisan tangan?
OCR paling andal untuk huruf cetak. Tulisan tangan jauh lebih sulit karena bentuk hurufnya berbeda pada tiap orang, sehingga hasilnya perlu diperiksa manusia atau dibaca dengan model vision.
Berapa skor confidence yang aman dipakai?
Tidak ada satu angka yang aman untuk semua kasus. Pada uji kami, skor 92 masih membawa total yang salah. Pakai skor rendah sebagai alasan meminta foto ulang, dan pakai aturan dokumen untuk memastikan isinya.
Apakah OCR General APIPedia bisa membaca PDF?
Belum. Menurut katalog, masukan harus berupa gambar PNG, JPEG, atau WebP dalam base64. Ubah halaman PDF menjadi gambar lebih dulu sebelum mengirimnya.
Kapan sebaiknya memakai OCR KTP, bukan OCR General?
Pakai OCR KTP bila Anda butuh field siap pakai seperti NIK dan nama. OCR General hanya mengembalikan teks mentah, sehingga pemilahan field menjadi pekerjaan Anda.
Langkah berikutnya: baca apa setelah ini?
Langkah paling praktis setelah memahami konsepnya adalah mencoba satu foto dokumen Anda sendiri di console.apipedia.id dan membandingkan hasilnya dengan teks aslinya. Untuk panduan pemasangan, baca API OCR KTP untuk membaca e-KTP dan memeriksa NIK. Bila aplikasi Anda juga menerima gambar QRIS, lanjutkan ke cara membaca dan memvalidasi QRIS toko. Sebelum memproses banyak foto sekaligus, pahami dulu rate limit dan error 429. Cara menyambungkan tool OCR ke asisten AI ada di panduan menghubungkan APIPedia lewat MCP.
Sumber
- Tesseract User Manual (tessdoc): versi, mesin LSTM, lisensi, dan dukungan bahasa
- Tesseract: Improving the quality of the output (binarisasi, resolusi, kemiringan, tepi, tabel)
- Tesseract: Neural nets in Tesseract 4.00 (pengenal baris teks berbasis LSTM)
- Tesseract.js: port WebAssembly dari Tesseract
- Katalog dan spesifikasi OpenAPI produk OCR di konsol APIPedia
Topik: #ocr #explainer #tesseract #ocr ktp #ai #api dokumen
Tentang penulis
Tim APIPedia — Tim Engineering APIPedia
Tim engineering di balik APIPedia yang membangun dan memelihara API data Indonesia - ongkir, OCR KTP, data wilayah, BMKG, hingga server MCP - dan menulis panduan integrasinya dari pengalaman langsung.