RAG Itu Seperti Ujian Open Book: Cara Kerja Embedding, Pencarian Vektor, dan Kapan Anda Membutuhkannya
Oleh Tim APIPedia, Tim Engineering APIPedia · Terbit · Diperbarui · 10 menit baca
RAG membuat AI membuka dokumen Anda dulu sebelum menjawab, seperti ujian open book. Ini cara kerja embedding, pencarian vektor, dan kapan RAG tidak perlu.
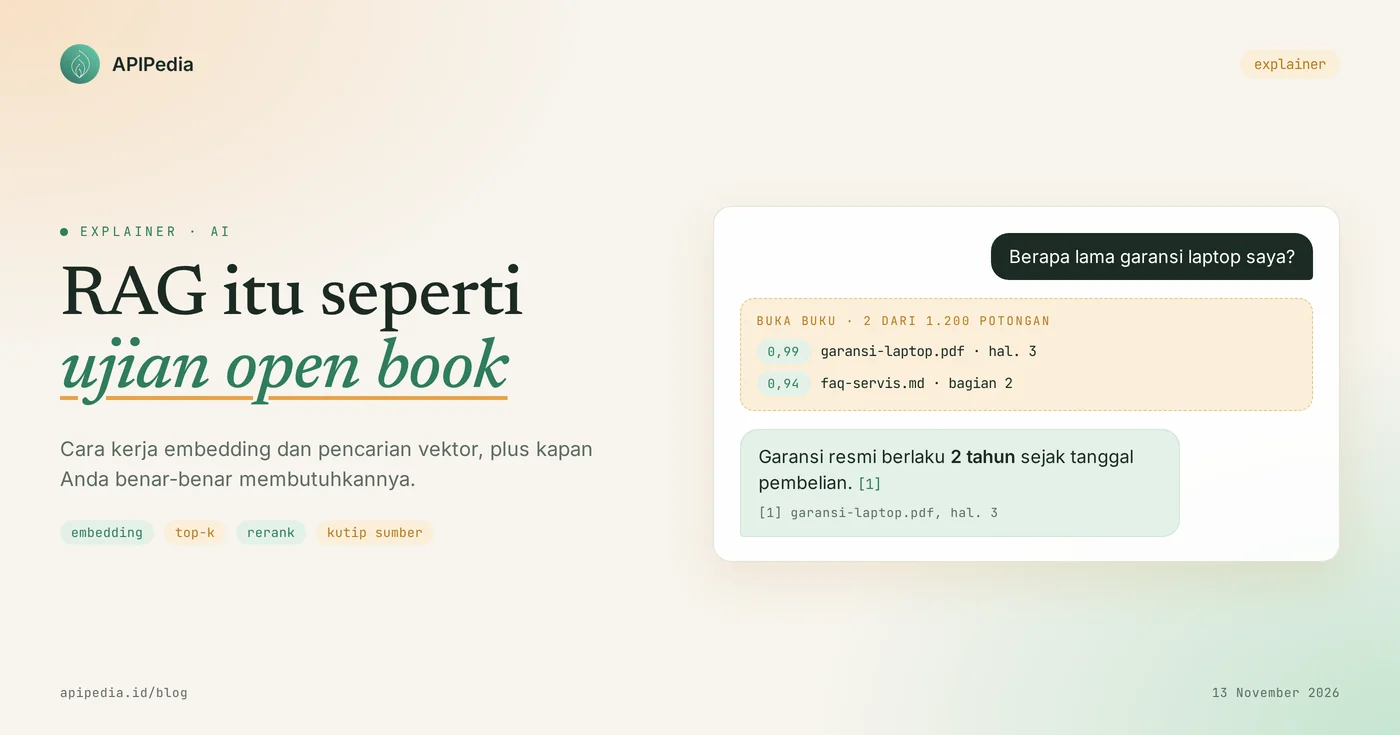
RAG (Retrieval-Augmented Generation) adalah teknik yang membuat model AI mencari dulu potongan dokumen yang relevan, lalu menjawab berdasarkan potongan itu. Analogi paling pas adalah ujian open book: model tidak perlu hafal isi buku Anda, cukup tahu cara membuka halaman yang tepat sebelum menulis jawaban. Alat pencarinya bernama embedding, yaitu teks yang diubah menjadi deret angka.
Konsep ini penting karena model AI hanya tahu apa yang ada di data latihnya. Ia tidak tahu kebijakan garansi toko Anda, SOP kantor Anda, atau harga yang berubah kemarin. Artikel ini menjelaskan RAG dan embedding dari nol, lengkap dengan contoh kode kecil yang bisa Anda jalankan, kesalahpahaman yang sering muncul, dan kapan Anda justru tidak membutuhkan RAG.
Ringkasan cepat: istilah apa saja yang perlu Anda tahu?
Ada enam istilah yang hampir selalu muncul saat orang membahas RAG. Tabel berikut memasangkan tiap istilah dengan padanannya di ujian open book.
| Istilah | Arti singkat | Padanan di ujian open book |
|---|---|---|
| RAG | Cari dokumen relevan dulu, baru model menjawab | Ujian yang boleh membuka buku |
| Chunk | Potongan dokumen, biasanya beberapa ratus token | Satu halaman atau satu paragraf buku |
| Embedding | Deret angka yang mewakili makna sebuah teks | Nomor rak yang menandai topik halaman |
| Indeks vektor | Tempat menyimpan semua embedding beserta teks aslinya | Daftar isi dan indeks di belakang buku |
| Top-k | Jumlah potongan paling mirip yang diambil, misalnya 5 atau 20 | Jumlah halaman yang sempat Anda buka |
| Rerank | Mengurutkan ulang hasil pencarian agar yang terbaik di atas | Memilah halaman mana yang benar-benar menjawab soal |
Apa itu RAG, dan kenapa mirip ujian open book?
RAG adalah cara menggabungkan dua jenis ingatan: ingatan bawaan model dan dokumen luar yang bisa dicari. Istilah ini diperkenalkan dalam makalah riset tahun 2020 berjudul "Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks". Makalah itu menyebut ingatan bawaan model sebagai memori parametrik, dan dokumen luar yang diindeks sebagai memori non-parametrik. Pada percobaan aslinya, dokumen luar tersebut adalah indeks vektor Wikipedia.
Bayangkan dua jenis ujian. Pada ujian tutup buku, Anda hanya mengandalkan hafalan. Kalau lupa, Anda cenderung mengarang jawaban yang terdengar meyakinkan. Pada ujian open book, Anda boleh membuka catatan, sehingga jawaban bisa dicek ke halamannya. Model AI tanpa RAG mirip peserta ujian tutup buku. Model dengan RAG mirip peserta open book yang tahu halaman mana yang harus dibuka.
Makalah tersebut juga mencatat dua masalah yang ingin diatasi: sulitnya menunjukkan asal sebuah jawaban, dan sulitnya memperbarui pengetahuan model. RAG menjawab keduanya. Sumber bisa dikutip, dan pengetahuan diperbarui cukup dengan mengganti dokumen.
Apa itu embedding?
Embedding adalah daftar angka pecahan yang mewakili makna sebuah teks. Dua teks yang maknanya berdekatan akan menghasilkan deret angka yang juga berdekatan, walaupun kata-katanya berbeda. Dokumentasi salah satu keluarga model embedding populer mendefinisikannya sebagai vektor berisi bilangan floating point, dengan panjang bawaan 1.536 angka untuk model kecil dan 3.072 angka untuk model besar.
Analogi sehari-harinya adalah rak di toko swalayan. Mi instan dan bumbu dapur berada di lorong yang berdekatan, sedangkan sabun cuci ada di lorong lain. Embedding memberi setiap kalimat "alamat lorong" berdasarkan maknanya. Untuk mencari kalimat yang relevan, komputer cukup mencari alamat yang paling dekat dengan alamat pertanyaan.
Bagaimana kedekatan makna dihitung?
Kedekatan dua embedding biasanya dihitung dengan kemiripan kosinus, yaitu angka yang makin mendekati 1 bila dua vektor makin searah. Skrip Python berikut memakai vektor mainan berisi 4 angka buatan tangan, supaya cara kerjanya terlihat jelas. Skrip ini sudah kami jalankan dan keluarannya dicantumkan di bawah.
import math

def cosine(a, b):
    dot = sum(x * y for x, y in zip(a, b))
    return dot / (math.sqrt(sum(x * x for x in a)) * math.sqrt(sum(y * y for y in b)))

# Vektor mainan 4 angka: [elektronik, garansi/waktu, makanan, perjalanan]
dokumen = {
    "Garansi resmi laptop berlaku 2 tahun":   [0.9, 0.9, 0.0, 0.0],
    "Servis gratis notebook selama 24 bulan": [0.9, 0.5, 0.0, 0.2],
    "Jadwal kereta Jakarta-Bandung":          [0.1, 0.3, 0.0, 0.9],
    "Resep sambal terasi pedas":              [0.0, 0.1, 0.95, 0.0],
}
pertanyaan = [0.8, 0.9, 0.0, 0.1]  # "Berapa lama garansi laptop?"

hasil = sorted(((cosine(pertanyaan, v), teks) for teks, v in dokumen.items()), reverse=True)
for skor, teks in hasil:
    print(f"{skor:.2f}  {teks}")

top_k = [teks for _, teks in hasil[:2]]
print("Dikirim ke model:", top_k)
0.99 Garansi resmi laptop berlaku 2 tahun
0.94 Servis gratis notebook selama 24 bulan
0.38 Jadwal kereta Jakarta-Bandung
0.08 Resep sambal terasi pedas
Dikirim ke model: ['Garansi resmi laptop berlaku 2 tahun', 'Servis gratis notebook selama 24 bulan']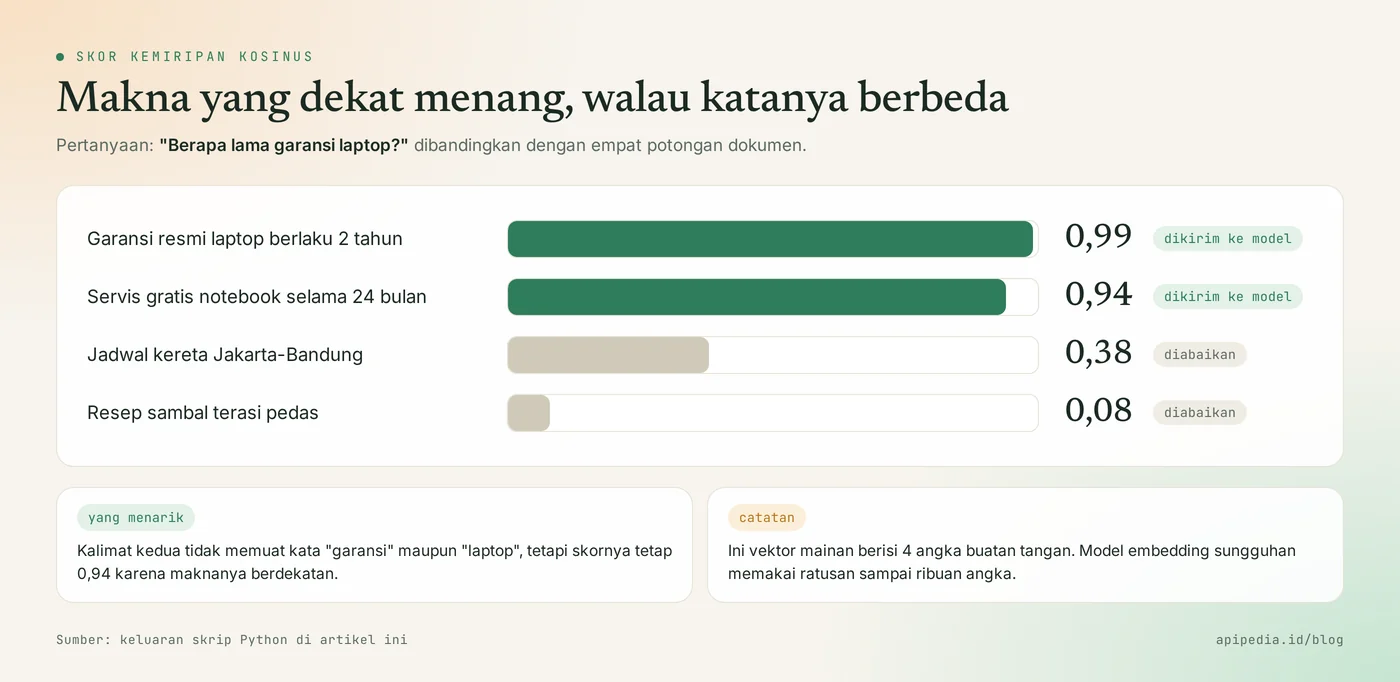
Perhatikan kalimat kedua. Ia tidak memuat kata "garansi" maupun "laptop", tetapi skornya 0,94 karena maknanya berdekatan. Inilah beda pencarian makna dengan pencarian kata kunci biasa. Pada model sungguhan, Anda tidak mengisi angkanya sendiri. Model embedding yang menghasilkannya, dan jumlahnya ratusan sampai ribuan angka per teks.
Bagaimana RAG bekerja langkah demi langkah?
RAG bekerja dalam dua tahap: menyiapkan indeks satu kali di awal, lalu mencari dan menjawab setiap kali ada pertanyaan. Tahap pertama ibarat merapikan catatan dan membuat daftar isi sebelum ujian. Tahap kedua adalah saat ujian berlangsung.
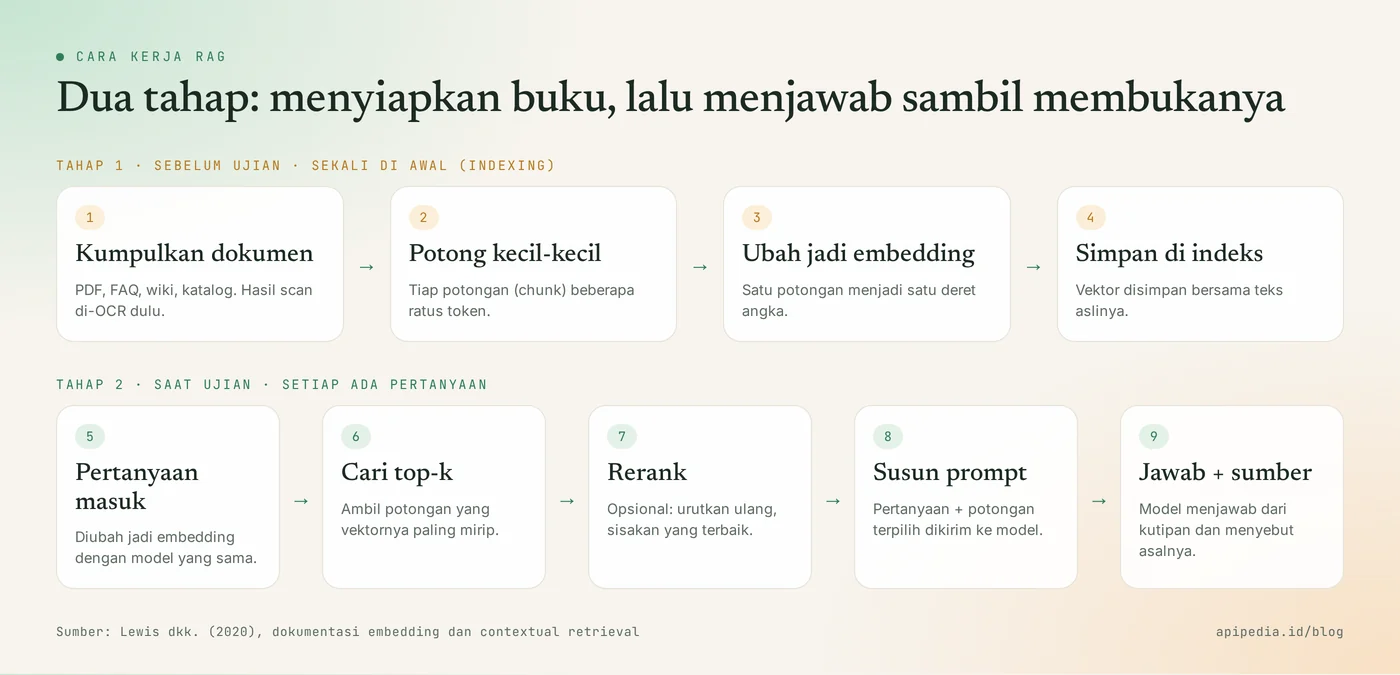
Tahap 1: menyiapkan buku (indexing)
- Kumpulkan dokumen. PDF, FAQ, wiki internal, atau katalog produk. Dokumen hasil scan perlu diubah menjadi teks dulu lewat OCR.
- Potong menjadi chunk. Dokumen dipecah menjadi potongan kecil, umumnya tidak lebih dari beberapa ratus token per potongan.
- Buat embedding. Setiap potongan dikirim ke model embedding dan kembali sebagai deret angka.
- Simpan di indeks. Deret angka disimpan bersama teks aslinya dan keterangan sumber, misalnya nama berkas dan nomor halaman.
Tahap 2: menjawab sambil membuka buku
- Pertanyaan diubah menjadi embedding dengan model yang sama seperti saat indexing.
- Cari top-k. Sistem mengambil sejumlah potongan dengan skor kemiripan tertinggi.
- Rerank (opsional). Model khusus mengurutkan ulang kandidat, lalu hanya yang terbaik yang dipakai. Sebuah panduan teknik retrieval mencontohkan pengambilan 150 kandidat yang disaring menjadi 20.
- Susun prompt. Pertanyaan dan potongan terpilih digabung, dengan instruksi agar model menjawab hanya dari potongan tersebut.
- Model menjawab dan menyebut sumbernya, sehingga pembaca bisa memeriksa.
Kapan Anda butuh RAG, dan kapan tidak?
Anda butuh RAG ketika dokumen terlalu banyak untuk ditempel ke prompt, sering berubah, atau jawabannya harus menyebut sumber. Untuk dokumen yang sedikit, cara paling sederhana sering kali lebih baik: tempel saja semuanya ke prompt. Panduan teknik retrieval yang sama memberi patokan kasar: basis pengetahuan di bawah 200.000 token, kira-kira 500 halaman, bisa langsung dimasukkan utuh.
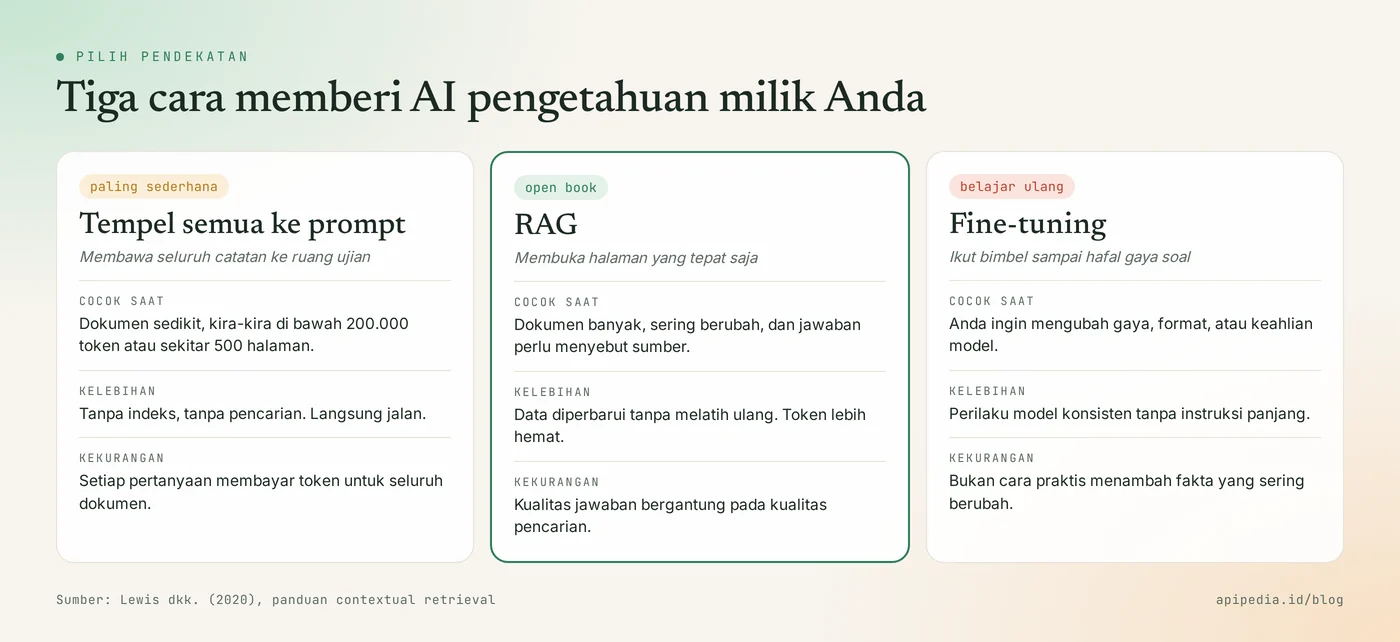
Perlu diingat, menempel seluruh dokumen berarti Anda membayar token untuk seluruh dokumen itu pada setiap pertanyaan. Kalau Anda belum akrab dengan cara token dihitung, baca dulu penjelasan kami tentang token AI yang mirip pulsa.
Apa yang sering disalahpahami soal RAG?
Kesalahpahaman paling umum adalah menganggap RAG sama dengan melatih model. Berikut beberapa anggapan yang perlu diluruskan.
- "RAG berarti melatih AI dengan data saya." Tidak. Bobot model tidak berubah sama sekali. Dokumen hanya ditempelkan ke prompt saat pertanyaan datang, lalu dilupakan setelah jawaban selesai.
- "Dengan RAG, AI tidak akan mengarang lagi." Belum tentu. RAG mengurangi risiko, tetapi kalau halaman yang diambil salah, jawabannya ikut salah. Dalam satu pengujian yang dipublikasikan, pencarian embedding biasa masih gagal menemukan potongan yang benar pada 5,7% kasus, dan baru turun menjadi 1,9% setelah beberapa teknik digabung.
- "Embedding itu enkripsi, jadi aman disebar." Bukan. Embedding adalah representasi makna, bukan pengaman. Perlakukan indeks vektor seperti dokumen aslinya, termasuk soal hak akses dan data pribadi.
- "Harus pakai database vektor khusus." Tidak selalu. Untuk beberapa ribu potongan, menghitung kemiripan satu per satu seperti skrip di atas masih cukup cepat. Database vektor baru terasa perlu saat data membesar.
- "Pencarian makna selalu lebih baik dari pencarian kata." Tidak untuk kode unik. Nomor pesanan, kode error, atau NIK lebih tepat dicari dengan pencocokan kata persis. Banyak sistem menggabungkan keduanya.
- "Model dengan konteks besar membuat RAG usang." Konteks besar memang membuat dokumen kecil bisa ditempel langsung. Tetapi untuk ribuan dokumen, biaya dan waktu tunggu tetap membuat pencarian lebih masuk akal.
Bagaimana cara memulai RAG pertama Anda?
Mulailah dari versi paling kecil yang bisa diuji: puluhan dokumen, satu model embedding, dan dua puluh pertanyaan uji. Beberapa tips yang menghemat waktu:
- Siapkan pertanyaan uji lebih dulu. Tulis 20 pertanyaan nyata beserta dokumen yang seharusnya terambil. Ini satu-satunya cara mengetahui apakah perubahan Anda memperbaiki atau merusak.
- Potong mengikuti struktur. Pecah per subjudul atau per butir FAQ, bukan per jumlah karakter secara buta. Ukuran, batas, dan tumpang-tindih potongan memengaruhi hasil pencarian.
- Simpan sumber di setiap potongan. Nama berkas, halaman, dan tanggal pembaruan membuat jawaban bisa dikutip dan dicek.
- Pakai model embedding yang sama untuk dokumen dan pertanyaan. Mengganti model berarti mengindeks ulang semuanya.
- Izinkan model berkata tidak tahu. Tambahkan instruksi: bila jawabannya tidak ada di kutipan, katakan tidak ditemukan.
Membuat embedding lewat AI Gateway APIPedia
AI Gateway APIPedia menyediakan endpoint /embeddings dan /rerank di bawah base URL https://api.apipedia.id/v1/ai, dengan format yang kompatibel dengan SDK OpenAI. Daftar model beserta harganya ada di GET /models. Contoh berikut mengikuti format tersebut; ganti NAMA_MODEL_EMBEDDING dengan salah satu model embedding dari daftar itu.
# 1) Lihat model yang tersedia, pilih yang bertipe embedding
curl https://api.apipedia.id/v1/ai/models \
  -H "Authorization: Bearer apk_xxx"

# 2) Ubah teks menjadi embedding
curl -X POST https://api.apipedia.id/v1/ai/embeddings \
  -H "Authorization: Bearer apk_xxx" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "NAMA_MODEL_EMBEDDING",
    "input": ["Garansi resmi laptop berlaku 2 tahun"]
  }'
Pada format ini, deret angkanya berada di data[0].embedding. Simpan angka itu bersama teks aslinya, lalu bandingkan dengan embedding pertanyaan memakai fungsi cosine seperti di skrip tadi. Untuk dokumen hasil scan, produk OCR General bisa mengubah gambar menjadi teks sebelum dipotong. Batas pemakaian tetap berlaku, jadi saat mengindeks ribuan potongan, kirim bertahap agar tidak terkena rate limit.
Pertanyaan yang sering diajukan
Apa bedanya RAG dengan fine-tuning?
RAG menambah pengetahuan lewat dokumen yang dicari saat pertanyaan datang, sedangkan fine-tuning mengubah bobot model lewat pelatihan tambahan. RAG cocok untuk fakta yang sering berubah. Fine-tuning cocok untuk mengubah gaya, format, atau keahlian model. Keduanya bisa dipakai bersamaan.
Apakah RAG membuat AI berhenti berhalusinasi?
Tidak sepenuhnya. RAG mengurangi halusinasi karena model menjawab dari kutipan, tetapi hasilnya bergantung pada kualitas pencarian. Minta model menyebut sumber dan izinkan ia menjawab "tidak ditemukan" agar kesalahan lebih mudah terlihat.
Apakah saya harus punya database vektor?
Tidak untuk memulai. Dengan beberapa ribu potongan, menyimpan embedding di berkas atau tabel biasa dan menghitung kemiripan satu per satu masih memadai. Pindah ke database vektor ketika jumlah data atau kecepatan pencarian mulai menjadi masalah.
Berapa ukuran chunk yang ideal?
Tidak ada angka tunggal. Praktik umum adalah beberapa ratus token per potongan, mengikuti batas alami seperti subjudul. Uji beberapa ukuran dengan daftar pertanyaan Anda sendiri, lalu pilih yang paling sering mengambil potongan yang benar.
Apakah embedding bisa dipakai selain untuk RAG?
Bisa. Embedding juga dipakai untuk pencarian, pengelompokan teks, rekomendasi, deteksi anomali, dan klasifikasi. RAG hanyalah salah satu pemakaian yang paling populer.
Ingin lanjut belajar konsep dasar lain? Baca apa itu MCP dan bedanya dengan API biasa, cara kerja token AI, cara kerja webhook, dan cara menjaga API key AI agar tidak dicuri. Kunci API untuk mencoba AI Gateway bisa dibuat di console.apipedia.id.
Sumber
- Lewis dkk., "Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks" (arXiv:2005.11401, 2020)
- OpenAI Developers: Vector embeddings (definisi, panjang vektor, kegunaan)
- Anthropic Engineering: Contextual Retrieval (chunk, BM25, rerank, patokan 200.000 token)
- Spesifikasi OpenAPI AI Gateway APIPedia
Topik: #rag #embedding #vector search #ai #explainer #ai gateway
Tentang penulis
Tim APIPedia — Tim Engineering APIPedia
Tim engineering di balik APIPedia yang membangun dan memelihara API data Indonesia - ongkir, OCR KTP, data wilayah, BMKG, hingga server MCP - dan menulis panduan integrasinya dari pengalaman langsung.