Jev di Cloud, Jev Lokal, dan Qev: Model AI yang Menjawab dengan Keputusan, Bukan Teks
Oleh Tim APIPedia, Tim Engineering APIPedia · Terbit · 12 menit baca
Jev dari TypeSafe AI menjawab ya/tidak, pilihan, dan skor dengan probabilitas. Ini cara pakai di cloud, opsi lokal, dan Qev berbasis Qwen.
Jev adalah model AI "System One" buatan TypeSafe AI yang tidak menulis teks, melainkan menjawab pertanyaan bertipe (ya/tidak, pilih satu, atau skor) lengkap dengan probabilitasnya. Jev dirilis dalam early access pada 15 September 2026, hanya tersedia sebagai API cloud, dengan tarif input $0,042 per 1 juta token dan output gratis. Bobot modelnya tidak dirilis, jadi "Jev lokal" yang beredar sebenarnya adalah proyek komunitas yang meniru cara kerjanya, dan Qev adalah salah satunya: model Qwen yang dilatih ulang supaya menjawab dengan format keputusan ala Jev.
Model seperti ini penting karena sebagian besar panggilan LLM di aplikasi sebenarnya hanya meminta keputusan: tiket ini masuk tim mana, komentar ini perlu dimoderasi atau tidak, prompt ini cukup dijawab model kecil atau butuh model besar. Artikel ini membahas cara kerja Jev, cara memakainya di cloud, pilihan menjalankannya di laptop sendiri, apa itu Qev, dan kapan Anda sebaiknya memilih masing-masing.
Ringkasan cepat: Jev cloud, Jev lokal, dan Qev itu apa?
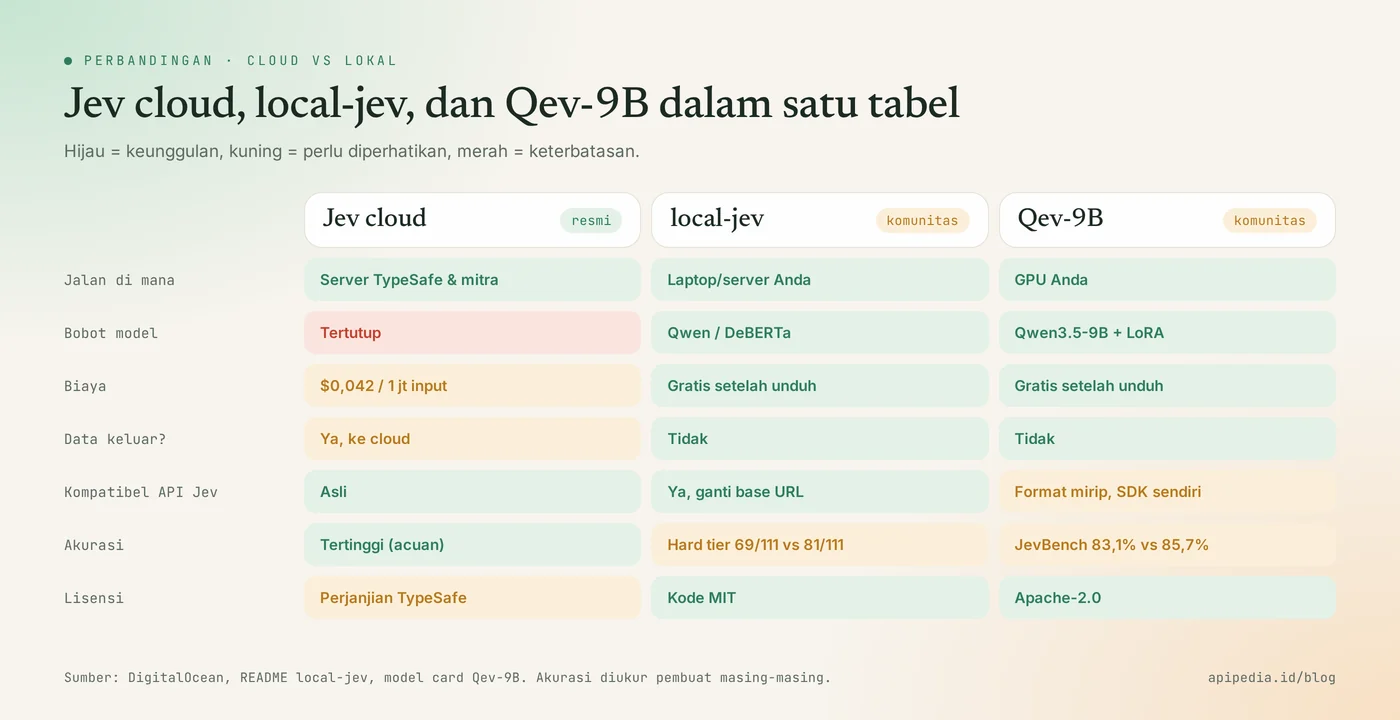
Jev cloud adalah layanan resmi TypeSafe AI, sedangkan Jev lokal dan Qev adalah proyek komunitas yang meniru format keputusan Jev dan bisa dijalankan di komputer sendiri.
| Item | Jev (cloud) | Jev lokal (local-jev) | Qev-9B |
|---|---|---|---|
| Pembuat | TypeSafe AI (resmi) | Proyek komunitas, tidak berafiliasi dengan TypeSafe | Proyek komunitas, tidak berafiliasi dengan TypeSafe |
| Jalan di mana | Server TypeSafe dan mitra (DigitalOcean, Vercel AI Gateway, dll.) | Komputer Anda, 127.0.0.1:8765 | Komputer Anda (GPU disarankan) |
| Dasar model | Tidak diungkap | Model Qwen atau DeBERTa yang dipakai sebagai penilai | Qwen3.5-9B-Base + LoRA + decision head |
| Biaya | Input $0,042 per 1 juta token, output gratis | Gratis setelah unduh model | Gratis setelah unduh model |
| Format jawaban | noul, choice, score + probabilitas | Sama dengan Jev (wire format identik) | Choice, Noul, Score + probabilitas |
| Lisensi | Tertutup, mengikuti perjanjian TypeSafe | Kode MIT, model ikut lisensi masing-masing | Apache-2.0 |
Apa itu Jev dan kenapa disebut model System One?
Jev disebut model System One karena dirancang untuk keputusan cepat, mengambil istilah System 1 (berpikir cepat dan intuitif) dari buku Thinking, Fast and Slow karya Daniel Kahneman. LLM biasa bekerja seperti System 2: menulis jawaban panjang token demi token. Jev hanya menilai, tanpa menulis jawaban panjang.
TypeSafe sendiri menyebut Jev sebagai "frontier-intelligence function call": state tidak terstruktur masuk, keputusan bertipe dengan probabilitas keluar.
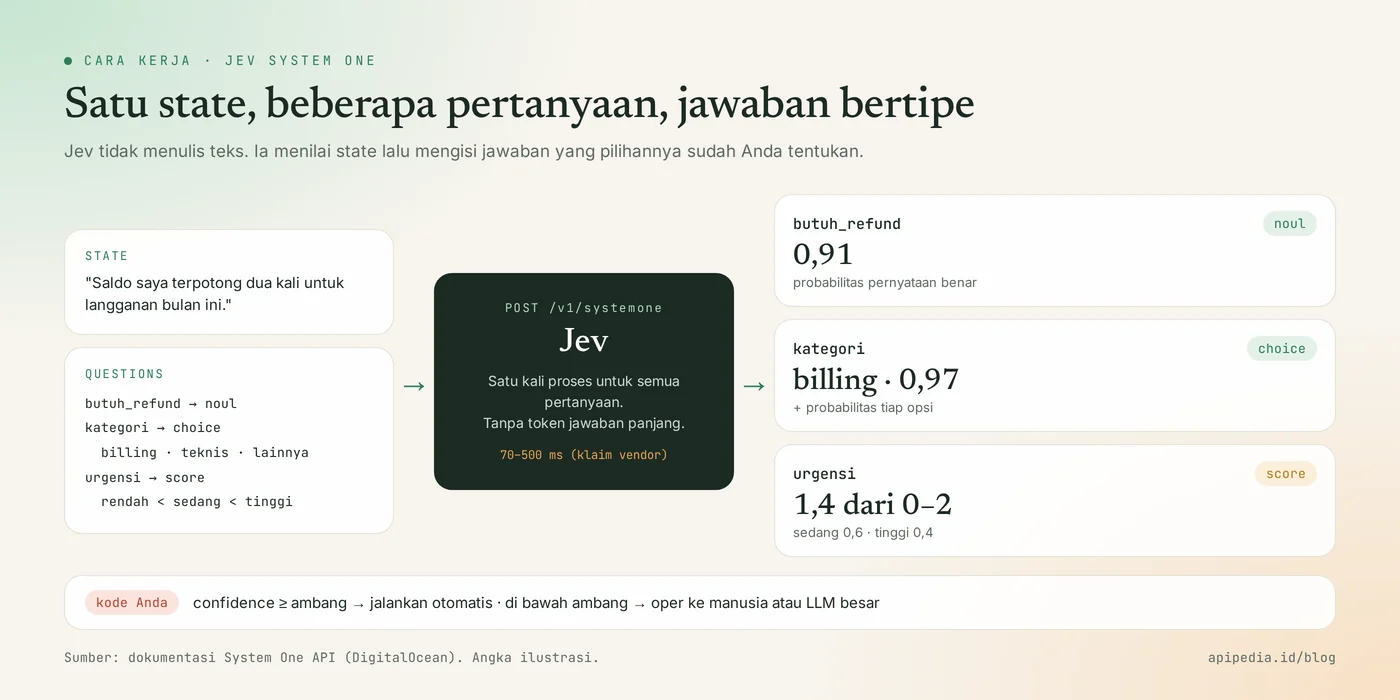
Cara pakainya juga berbeda. Anda tidak mengirim percakapan (messages), melainkan dua hal: state berisi teks yang mau dinilai (tiket, transaksi, komentar), dan questions berisi satu atau beberapa pertanyaan bertipe. Karena pilihan jawaban sudah ditentukan sebelum panggilan, hasilnya selalu sesuai skema dan bisa langsung dipakai kode Anda untuk bercabang.
Tiga tipe pertanyaan di Jev
noul(ya/tidak). Jev mengembalikan probabilitas bahwa pernyataan diinstructionsbenar, misalnya 0,91 untuk "Pelanggan butuh refund?". Tipe ini tidak memakaicriteria.choice(pilih satu). Anda memberi daftar opsi beserta deskripsinya, Jev memilih satu dan memberi probabilitas untuk setiap opsi.score(skor berurutan). Anda memberi tingkat dari terendah ke tertinggi, misalnya rendah–sedang–tinggi. Jev mengembalikan skor rata-rata tertimbang dari posisi tingkat, probabilitas tiap tingkat, dan nilaiconfidence.
Satu permintaan boleh berisi beberapa pertanyaan sekaligus, dan semuanya dijawab dalam satu kali proses. Satu catatan nama: TypeSafe AI yang membuat Jev tidak ada hubungannya dengan perusahaan Scala bernama Typesafe (sekarang Lightbend).
Bagaimana cara memakai Jev di cloud?
Jev di cloud dipanggil lewat POST https://api.typesafe.ai/v1/systemone dengan header Authorization: Bearer, memakai kunci dari konsol TypeSafe. Model jev-latest saat ini mengarah ke jev-1.13.0. Kalau Anda mengatur ambang batas (threshold) berdasarkan hasil uji, pin versinya, karena alias jev-latest bisa pindah saat ada rilis baru.
Contoh berikut menilai satu tiket dengan tiga tipe pertanyaan dalam satu panggilan:
curl -sS -X POST https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "jev-1.13.0",
    "state": "Tiket: Saldo saya terpotong dua kali untuk langganan bulan ini.",
    "questions": {
      "butuh_refund": {
        "type": "noul",
        "instructions": "Apakah pelanggan butuh refund?"
      },
      "kategori": {
        "type": "choice",
        "instructions": "Kategori mana yang paling cocok untuk tiket ini?",
        "criteria": {
          "billing": "Masalah tagihan, potongan saldo, atau pembayaran",
          "teknis": "Error atau gangguan produk",
          "lainnya": "Selain dua kategori di atas"
        }
      },
      "urgensi": {
        "type": "score",
        "instructions": "Seberapa mendesak tiket ini?",
        "criteria": [{"label": "rendah"}, {"label": "sedang"}, {"label": "tinggi"}]
      }
    }
  }'
Bentuk jawabannya (angka di bawah hanya ilustrasi, bukan hasil uji):
{
  "model": "jev-1.13.0",
  "answers": {
    "butuh_refund": { "type": "noul", "noul": 0.91 },
    "kategori": {
      "type": "choice",
      "choice": "billing",
      "probabilities": { "billing": 0.97, "teknis": 0.02, "lainnya": 0.01 },
      "confidence": 0.97
    },
    "urgensi": {
      "type": "score",
      "score": 1.4,
      "legend": { "0": "rendah", "1": "sedang", "2": "tinggi" },
      "probabilities": { "0": 0.0, "1": 0.6, "2": 0.4 },
      "confidence": 0.6
    }
  },
  "usage": { "input_tokens": 160, "output_tokens": 20 }
}
Pakai probabilitas sebagai gerbang, bukan sebagai kebenaran
Kekuatan utama Jev ada pada probabilitasnya: kode Anda bisa memutuskan sendiri kapan hasil cukup yakin untuk dieksekusi otomatis, dan kapan harus dioper ke manusia atau ke LLM yang lebih besar. Pola sederhananya dalam Python:
import os, requests

def nilai_tiket(teks):
    r = requests.post(
        "https://api.typesafe.ai/v1/systemone",
        headers={"Authorization": f"Bearer {os.environ['TYPESAFE_API_KEY']}"},
        json={
            "model": "jev-1.13.0",
            "state": teks,
            "questions": {
                "kategori": {
                    "type": "choice",
                    "instructions": "Tim mana yang harus menangani tiket ini?",
                    "criteria": {"billing": "Tagihan dan refund", "teknis": "Error produk"},
                }
            },
        },
        timeout=10,
    )
    r.raise_for_status()
    return r.json()["answers"]["kategori"]

hasil = nilai_tiket("Saldo saya terpotong dua kali bulan ini.")
if hasil["confidence"] >= 0.85:      # ambang hasil uji Anda sendiri
    print("Kirim otomatis ke tim", hasil["choice"])
else:
    print("Ragu-ragu, oper ke agen manusia")
Lewat mana saja Jev bisa diakses?
- API TypeSafe langsung di
api.typesafe.ai, kunci dibuat diconsole.typesafe.ai. - DigitalOcean Serverless Inference di
https://inference.do-ai.run/v1/systemonedengan ID modeltypesafe-jev-1.13.0. - Vercel AI Gateway dengan model
typesafe-ai/jev. Di AI SDK, tipe ya/tidak disebutboolean, bukannoul. - Agregator API lain yang mengikuti format System One, dengan tarif masing-masing (bisa sedikit berbeda dari tarif TypeSafe).
Batas yang tercatat di dokumentasi DigitalOcean: total permintaan maksimal 64K token, state ditambah pertanyaan terpanjang maksimal 32K token, dan belum mendukung input gambar, audio, video, maupun streaming.
Seberapa cepat dan murah Jev?
TypeSafe mengklaim latensi 70–500 milidetik dari ujung ke ujung, dengan input $0,042 per 1 juta token dan output gratis. Angka latensi ini diukur sendiri oleh TypeSafe di infrastruktur mereka, jadi uji ulang di jaringan Anda, apalagi dari Indonesia ke server luar negeri. Karena yang ditagih hanya input, biaya bergantung pada panjang state yang Anda kirim, bukan pada jawaban. Kalau Anda belum akrab dengan hitungan token, baca dulu penjelasan token AI seperti pulsa.
Bisakah Jev dijalankan di lokal?
Tidak, Jev yang asli tidak bisa dijalankan di lokal karena TypeSafe tidak merilis bobot maupun arsitektur modelnya. Yang bisa Anda jalankan di laptop adalah server atau model komunitas yang meniru kontrak API Jev: menerima state dan questions yang sama, lalu mengembalikan jawaban bertipe dengan probabilitas. Akurasinya berbeda dari Jev asli, jadi perlakukan sebagai alternatif, bukan salinan.
local-jev: server Jev-compatible yang berjalan offline
local-jev adalah server lokal yang memakai wire format yang sama dengan API Jev, sehingga SDK resmi typesafe-sdk bisa dipakai tanpa perubahan kode, cukup ganti base URL. Setelah model terunduh, tidak ada data yang keluar dari komputer Anda. Butuh Python 3.10+ dan berjalan di macOS Apple Silicon, Linux, atau Windows lewat WSL2.
git clone https://github.com/amithgc/local-jev && cd local-jev
uv venv --python 3.12 .venv
uv pip install --python .venv/bin/python -e .

# daftar model yang tersedia, lalu jalankan dengan model pilihan
.venv/bin/local-jev models
.venv/bin/local-jev serve --model llm-qwen3.5-4b

# arahkan SDK TypeSafe ke server lokal
export TYPESAFE_BASE_URL=http://127.0.0.1:8765
export TYPESAFE_API_KEY=local

# uji satu pertanyaan ya/tidak
curl -s http://127.0.0.1:8765/v1/systemone \
  -H "Content-Type: application/json" \
  -d '{"state": "Kartu saya ditagih dua kali bulan ini.",
       "questions": {"refund": {"type": "noul", "instructions": "Pelanggan ingin uangnya kembali"}}}'
Pilihan model yang dicatat pembuatnya, berikut skor di set publik JevBench (benchmark tugas keputusan ala Jev):
| Model | JevBench publik | Ukuran unduhan | Catatan |
|---|---|---|---|
llm-qwen3.5-4b | 80,5% | 9,32 GB | Default bila sudah ada di disk, butuh sekitar 8,5 GB memori |
llm-qwen3-4b | 70,1% | 8,04 GB | Lebih cepat |
llm-qwen3.5-2b | 66,2% | 4,55 GB | Kompromi ukuran |
llm-qwen2.5-1.5b | 58,9% | 3,09 GB | Memori paling kecil di keluarga Qwen |
nli-deberta-large | 54,1% | 0,87 GB | Paling kecil, diunduh saat pertama jalan |
Pembuatnya terbuka soal batasannya: ini proyek riset, angka diukur di Apple M4 Max (jalan di CPU saja bisa tetapi lambat), dan di tingkat soal sulit JevBench model default menjawab benar 69 dari 111 soal, sedangkan Jev asli 81 dari 111. Kunci API lokal hanya melindungi /v1/*, jadi biarkan server tetap di localhost atau di belakang proxy Anda sendiri.
Alternatif lokal lain yang beredar
- OpenJev, implementasi ulang kontrak keputusan Jev dalam TypeScript (
npm run dev, lalu bukalocalhost:3001). Ia memakai model chat apa pun sebagai penilai lewat endpoint OpenAI-compatible, termasuk server model lokal. Saat ditinjau, repositorinya belum punya file lisensi, jadi baca kodenya dan jangan dipakai komersial dulu. - JEV-9B GGUF, kuantisasi Qwen3.5-9B yang sudah digabung LoRA System-1 (Q8_0 sekitar 8,86 GiB). Bisa dimuat llama.cpp atau Ollama, tetapi llama.cpp biasa hanya menjalankan chat teks. Decision head-nya butuh runtime terpisah yang aksesnya lewat izin pembuat.
Apa itu Qev, "gabungan" Jev dan Qwen?
Qev adalah model Qwen yang dilatih ulang menjadi model keputusan dengan format jawaban ala Jev: diberi konteks, pertanyaan, dan opsi jawaban, lalu mengembalikan keputusan beserta probabilitas tiap opsi. Jadi Qev bukan hasil menggabungkan bobot Jev dengan Qwen (bobot Jev tertutup), melainkan menggabungkan cara kerja Jev dengan bobot terbuka Qwen. Hasilnya bisa diunduh dan dijalankan sendiri.
Versi yang paling lengkap dokumentasinya adalah Qev-9B (v0.2.0) berlisensi Apache-2.0. Strukturnya:
- Basis:
Qwen/Qwen3.5-9B-Base, diunduh terpisah oleh loader sesuai versi yang dikunci di konfigurasi. - Adaptasi: LoRA rank 64 (alpha 128), ditambah decision head (proyeksi 4096→256, dua lapisan Transformer 4-head, dan penilai skalar) serta interaction gate.
- Tipe tugas: Choice, Noul (ya/tidak), dan Score (rating berurutan), sama seperti Jev.
- Paket unduhan adaptasi: sekitar 690 MiB, di luar bobot Qwen.
Cara mencoba Qev-9B
Pembuatnya menyarankan Python 3.12 dan PyTorch 2.8.0 yang cocok dengan hardware Anda:
git clone https://github.com/QiqianFu/Qev.git
cd Qev
python -m pip install -e .
from qev import Qev
model = Qev.from_pretrained("AustinFu/Qev-9B", revision="main", device="cuda")
hasil = model.predict({
"state": "Pelanggan melapor saldo terpotong dua kali dan minta bantuan segera.",
"questions": {
"tim": {
"type": "choice",
"instructions": "Tim mana yang harus menangani kasus ini?",
"criteria": {"billing": "Tagihan dan refund", "pengiriman": "Masalah kiriman"},
}
},
})
print(hasil["tim"]["choice"])
print(hasil["tim"]["probabilities"])Seberapa bagus Qev dibanding Qwen biasa dan Jev?
Dalam uji yang dilakukan pembuatnya sendiri, Qev-9B mengungguli basis Qwen3.5-9B di ketujuh benchmark, tetapi masih di bawah Jev di enam dari tujuh tes, dengan selisih terbesar di MMLU-Pro (pengetahuan umum).
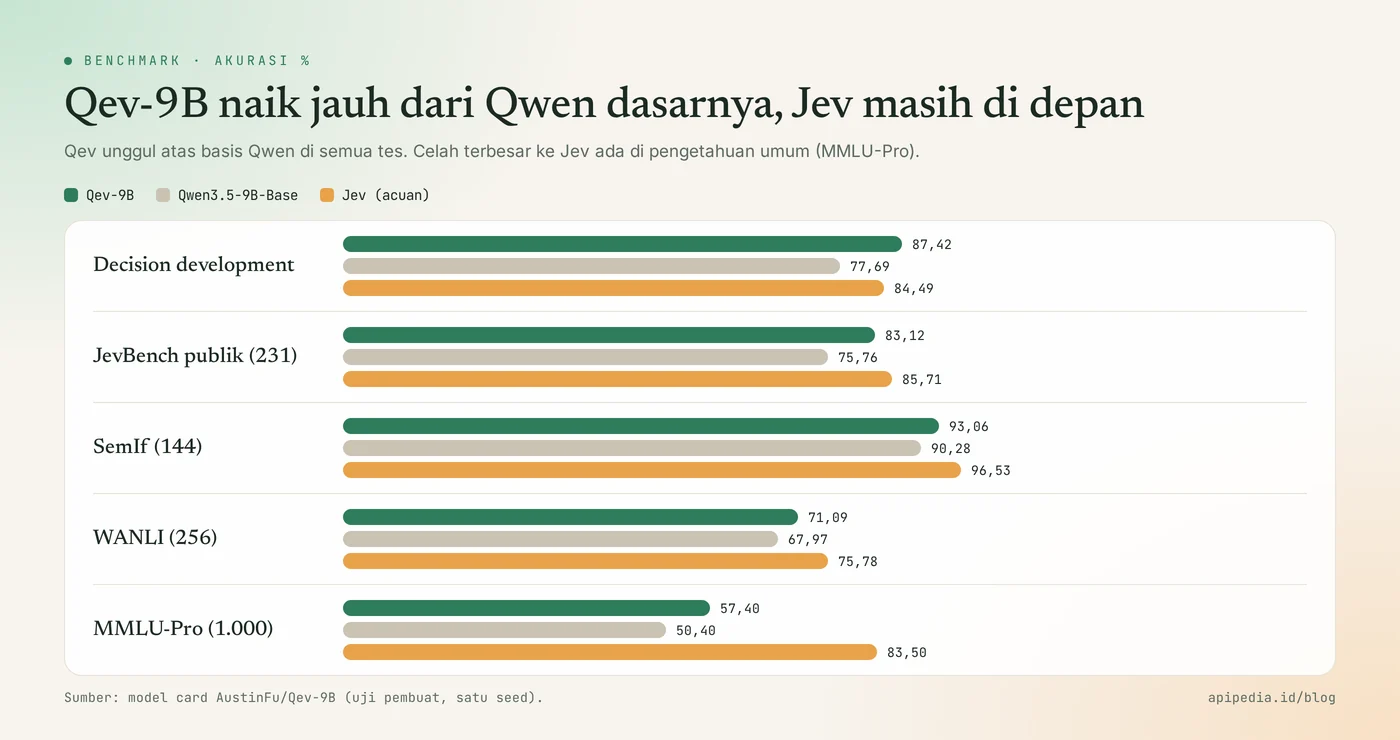
| Benchmark (akurasi %) | Jev (acuan) | Qwen3.5-9B-Base | Qev-9B |
|---|---|---|---|
| Decision development (clean) | 84,49 | 77,69 | 87,42 |
| Transfer development (clean) | 85,67 | 74,39 | 83,99 |
| JevBench publik (231 soal) | 85,71 | 75,76 | 83,12 |
| SemIf (144 soal tulisan tangan) | 96,53 | 90,28 | 93,06 |
| WANLI (256) | 75,78 | 67,97 | 71,09 |
| MMLU-Pro (1.000) | 83,50 | 50,40 | 57,40 |
Baca angka ini dengan hati-hati. Pembuatnya mencatat model yang dirilis berasal dari satu seed, benchmark publik ikut terlihat selama iterasi riset, dan kalibrasi serta keandalan produksi belum dibuktikan. Uji di data Anda sendiri sebelum menentukan ambang.
Kenapa ada beberapa "QEV" di Hugging Face?
Nama Qev atau QEV dipakai beberapa proyek komunitas yang idenya sama: Qwen ditambah adapter dan head keputusan ala Jev. Contohnya QEV-9B dari QueryPie (Qwen3.5 dengan LoRA yang sudah digabung, lisensi riset sendiri), QEV-2B (multimodal teks dan gambar di atas Qwen3.5-2B), dan qev-0.8b (di atas Qwen3.5-0.8B, dilengkapi server HTTP lokal). Semuanya bukan rilis resmi TypeSafe maupun Qwen. Cek lisensi masing-masing sebelum dipakai untuk produk berbayar.
Kapan memilih Jev cloud, Jev lokal, atau Qev?
Pilih Jev cloud kalau Anda butuh akurasi dan kecepatan terbaik tanpa mengurus GPU, pilih local-jev atau Qev kalau datanya tidak boleh keluar dari server Anda atau volumenya sangat besar.
| Kebutuhan Anda | Pilihan yang cocok | Alasan |
|---|---|---|
| Routing tiket atau moderasi untuk produk yang sudah jalan | Jev cloud | Paling akurat di JevBench, latensi rendah, tanpa infrastruktur |
| Data sensitif (tiket pelanggan, dokumen internal) | local-jev atau Qev | Tidak ada data yang keluar dari mesin Anda |
| Ingin kode tetap kompatibel dengan Jev | local-jev | Wire format sama, cukup ganti base URL |
| Ingin fine-tune ulang untuk kasus sendiri | Qev-9B | Bobot adaptasi dan kode terbuka, Apache-2.0 |
| Laptop tanpa GPU | Jev cloud, atau local-jev dengan model kecil | Model 9B terlalu berat di CPU |
Pola yang paling sering dipakai: router di depan LLM
Pola yang banyak dicontohkan komunitas adalah memasang model keputusan sebagai "satpam" di depan LLM. Setiap prompt dinilai dulu: cukup dijawab model kecil lokal, butuh model besar di cloud, atau harus ditolak. Karena satu keputusan hanya butuh ratusan milidetik dan input token yang sedikit, pola ini bisa menghemat banyak biaya LLM. Ingat juga batasnya: Jev hanya memberi angka, bukan alasan, jadi simpan log keputusan untuk audit, dan pecah pertanyaan rumit menjadi beberapa pertanyaan sederhana.
Pertanyaan yang sering diajukan
Apakah Jev bisa dipakai untuk chat atau menulis kode?
Tidak. Jev tidak menghasilkan teks bebas, jadi tidak cocok untuk chat, penjelasan, atau pembuatan kode. Jev juga tidak memanggil tool sendiri. Ia bekerja sebagai lapisan keputusan di samping agen atau LLM yang sudah Anda punya.
Apakah jawaban Jev pasti benar karena selalu sesuai skema?
Tidak. Format jawaban dijamin valid, tetapi isinya tetap bisa salah dengan yakin. Karena itu gunakan probabilitas dan confidence sebagai ambang, lalu oper kasus yang ragu ke manusia atau model yang lebih besar.
Apakah Qev sama dengan Jev versi open source?
Tidak. Qev adalah proyek komunitas yang melatih Qwen supaya meniru format keputusan Jev. Bobot Jev tidak pernah dirilis, sehingga Qev tidak memuat bagian dari model Jev dan akurasinya berbeda.
Berapa biaya memakai Jev di cloud?
Di API TypeSafe, input ditagih $0,042 per 1 juta token dan output gratis (per November 2026). Penyedia perantara bisa memasang tarif sedikit berbeda, jadi cek halaman harga penyedia yang Anda pakai.
Butuh hardware apa untuk menjalankan versi lokal?
Untuk local-jev dengan model default llm-qwen3.5-4b, siapkan sekitar 8,5 GB memori dan unduhan 9,32 GB. Model nli-deberta-large jauh lebih ringan (0,87 GB). Qev-9B dan JEV-9B GGUF berbasis model 9B, jadi GPU dengan VRAM sekitar 12 GB ke atas lebih nyaman.
Kalau Anda membangun aplikasi yang memanggil banyak API AI sekaligus, baca juga arti rate limit dan error 429 supaya router Anda tidak tumbang saat trafik naik, serta cara kerja webhook untuk menyambungkan hasil keputusan ke sistem lain.
Sumber
- DigitalOcean Docs: How to Send Requests to a Model Using the System One API
- DigitalOcean: What is Jev, TypeSafe AI's System One model
- Vercel: What is Jev, TypeSafe AI's System One model?
- GitHub: amithgc/local-jev, server System One lokal dan offline
- Hugging Face: AustinFu/Qev-9B, decisions grounded in Qwen
- Hugging Face: querypieai/QEV-9B
- Hugging Face: VrKnight/JEV-9B-GGUF
Topik: #ai #jev #typesafe #qwen #model keputusan #llm lokal
Tentang penulis
Tim APIPedia — Tim Engineering APIPedia
Tim engineering di balik APIPedia yang membangun dan memelihara API data Indonesia - ongkir, OCR KTP, data wilayah, BMKG, hingga server MCP - dan menulis panduan integrasinya dari pengalaman langsung.