Prompt Caching Itu Seperti Bumbu Dasar Nasi Goreng: Cara Kerja, Hitungan Hemat, dan Kapan Malah Rugi
Oleh Tim APIPedia, Tim Engineering APIPedia · Terbit · Diperbarui · 11 menit baca
Prompt caching itu seperti bumbu dasar nasi goreng: awalan prompt diolah sekali, lalu dipakai ulang dengan tarif mulai 0,1x. Ini cara kerja dan hitungannya.
Prompt caching adalah fitur penyedia model AI yang menyimpan hasil olahan bagian awal prompt, sehingga saat bagian yang sama dikirim lagi, token itu ditagih jauh lebih murah, umumnya mulai 0,1 kali harga input biasa. Cara paling gampang memahaminya: prompt caching itu seperti bumbu dasar di gerobak nasi goreng. Abangnya tidak mengulek bawang dan cabai dari nol untuk setiap pesanan. Bumbu dasar disiapkan sekali, lalu tinggal disendok untuk pesanan berikutnya.
Bagi developer dan pemilik bisnis yang memakai AI lewat API, fitur ini penting karena sebagian besar tagihan sering datang dari teks yang sama dan dikirim berulang: instruksi sistem, SOP, katalog produk, atau definisi tool. Artikel ini membahas cara kerja prompt caching, hitungan hematnya dengan angka nyata, kapan fitur ini malah bikin rugi, dan kesalahan yang paling sering membuat cache meleset.
Ringkasan cepat: apa yang perlu Anda tahu?
| Istilah | Artinya |
|---|---|
| Prompt caching | Menyimpan hasil olahan awalan prompt di sisi penyedia model supaya tidak diproses ulang dari nol |
| Awalan (prefix) | Bagian prompt dari karakter pertama sampai titik batas cache. Harus sama persis agar cache terpakai |
| Cache write | Request pertama yang menulis simpanan. Di sebagian penyedia tarifnya 1,25 kali input biasa |
| Cache read atau cache hit | Request berikutnya yang memakai simpanan. Tarif umumnya 0,1 kali input biasa |
| Cache miss | Simpanan tidak terpakai karena awalan berubah, terlalu pendek, atau sudah kedaluwarsa |
| TTL (masa simpan) | Lama simpanan bertahan, mulai 5 menit sampai beberapa jam tergantung penyedia dan pengaturan |
| Batas minimum | Awalan harus cukup panjang, mulai 512 sampai 4.096 token tergantung model |
Apa itu prompt caching?
Prompt caching adalah cara penyedia model menghindari kerja ulang untuk teks yang sudah pernah dibacanya. Setiap kali Anda memanggil model, seluruh prompt dibaca dari awal: instruksi sistem, riwayat percakapan, lalu pertanyaan terbaru. Model tidak punya ingatan antar-request, jadi aplikasi Anda mengirim ulang semuanya setiap saat.
Bayangkan chatbot layanan pelanggan sebuah toko online. Instruksi sistemnya berisi SOP retur, jam operasional, dan daftar produk, panjangnya 4.000 token. Pelanggan hanya mengetik "ongkir ke Malang berapa?", sekitar 10 token. Tanpa caching, Anda membayar 4.010 token input untuk pertanyaan sependek itu, dan membayarnya lagi untuk pertanyaan berikutnya.
Di sinilah analogi bumbu dasar bekerja. Instruksi sistem adalah bumbu dasar: sama untuk semua pesanan. Pertanyaan pelanggan adalah tambahan per piring: telur, sosis, atau level pedas. Dengan caching, bumbu dasar diolah sekali, lalu pesanan berikutnya hanya membayar "ongkos menyendok" yang jauh lebih murah.
Kalau istilah token masih terasa asing, baca dulu penjelasan token AI itu seperti pulsa, karena prompt caching pada dasarnya adalah diskon untuk "pulsa" yang terpakai berulang.
Bagaimana cara kerja prompt caching?
Prompt caching bekerja dengan mencocokkan awalan prompt: kalau bagian awal request baru sama persis dengan yang pernah disimpan, penyedia model memakai simpanan itu dan hanya memproses sisanya. Yang disimpan bukan teks jawaban, melainkan hasil olahan internal model atas awalan tersebut.
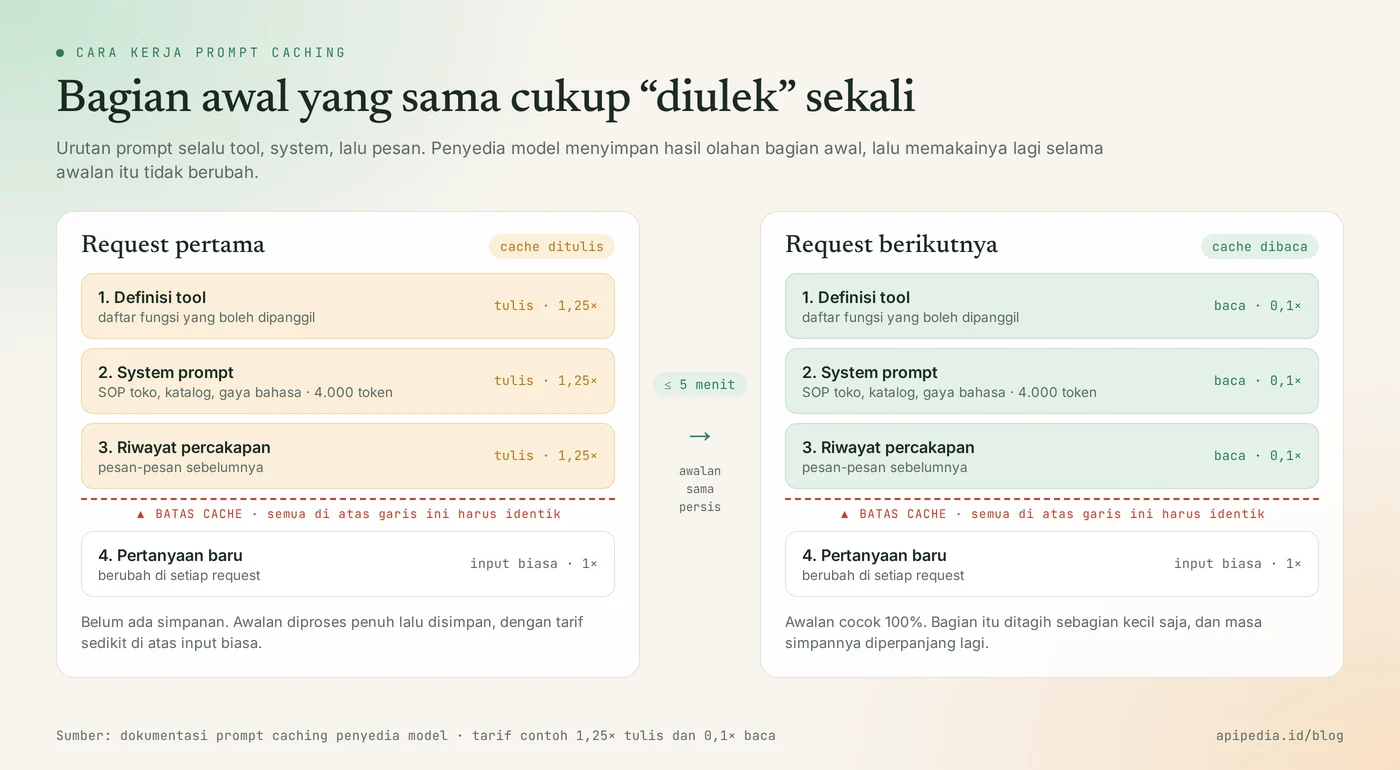
- Request pertama: cache ditulis. Belum ada simpanan, jadi seluruh awalan diproses penuh lalu disimpan. Di sebagian penyedia, langkah ini ditagih sedikit lebih mahal dari input biasa, misalnya 1,25 kali.
- Request berikutnya: cache dibaca. Kalau awalannya identik dan simpanan belum kedaluwarsa, bagian itu ditagih tarif baca, umumnya 0,1 kali harga input.
- Bagian setelah batas cache diproses seperti biasa dengan tarif input normal. Token output juga tetap ditagih penuh.
Kenapa urutan prompt penting?
Urutan prompt penting karena pencocokan selalu dimulai dari karakter pertama. Dokumentasi resmi penyedia model menyebut syaratnya 100 persen identik sampai titik batas cache. Urutan yang dipakai adalah definisi tool, lalu instruksi sistem, lalu pesan. Kalau ada satu kata berubah di depan, semua simpanan di belakangnya ikut gugur.
Dalam analogi gerobak nasi goreng: kalau resep bumbu dasarnya diganti sedikit saja, stok yang sudah ada tidak bisa dipakai dan harus mengulek ulang. Karena itu, taruh bagian yang tetap di depan dan bagian yang berubah-ubah di belakang.
Berapa lama simpanan bertahan?
Simpanan cache hanya bertahan sebentar, mulai 5 menit sampai beberapa jam tergantung penyedia. Pada salah satu penyedia, masa simpan bawaannya 5 menit dan diperpanjang gratis setiap kali simpanan itu dipakai. Ada juga pilihan masa simpan 1 jam dengan tarif tulis lebih tinggi, yaitu 2 kali harga input. Bumbu dasar pun begitu: selama gerobak ramai, stok terus terpakai dan diisi ulang. Begitu sepi terlalu lama, bumbunya dibuang.
Berapa hematnya?
Dengan tarif tulis 1,25 kali dan tarif baca 0,1 kali, biaya awalan prompt bisa turun sekitar 89 persen untuk 100 request, dan batas atasnya 90 persen. Angka ini hanya berlaku untuk bagian awalan yang di-cache, bukan total tagihan.
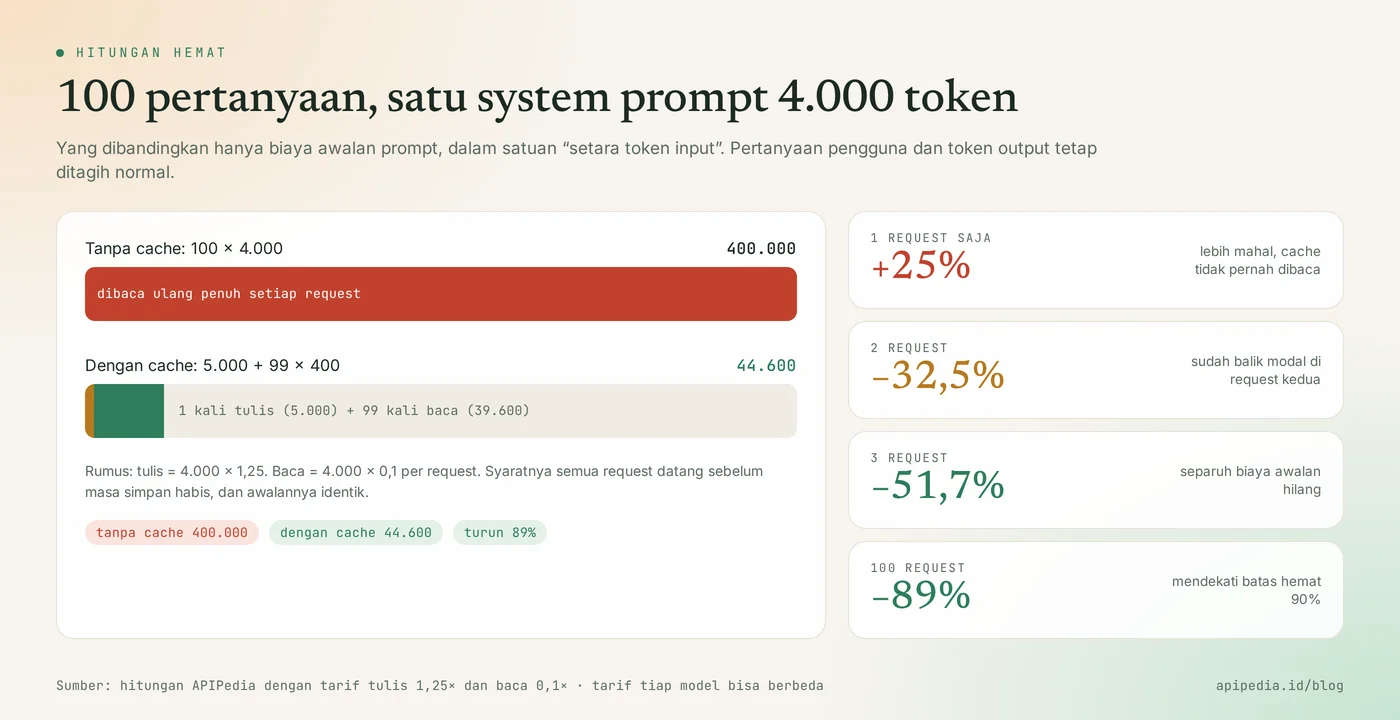
Kami menghitungnya dengan skrip Python kecil berikut. Satuannya "setara token input", jadi tinggal dikalikan harga per token model yang Anda pakai.
def biaya_awalan(token_awalan, jumlah_request, tulis=1.25, baca=0.1):
    tanpa = token_awalan * jumlah_request
    dengan = token_awalan * tulis + token_awalan * baca * (jumlah_request - 1)
    return tanpa, dengan, 1 - dengan / tanpa

for n in (1, 2, 3, 100):
    tanpa, dengan, hemat = biaya_awalan(4000, n)
    print(f"{n:>3} request | tanpa cache {tanpa:>7,.0f} | dengan cache {dengan:>7,.0f} | hemat {hemat:+.2%}")
Hasilnya saat dijalankan:
  1 request | tanpa cache   4,000 | dengan cache   5,000 | hemat -25.00%
  2 request | tanpa cache   8,000 | dengan cache   5,400 | hemat +32.50%
  3 request | tanpa cache  12,000 | dengan cache   5,800 | hemat +51.67%
100 request | tanpa cache 400,000 | dengan cache  44,600 | hemat +88.85%
Kapan prompt caching malah rugi?
Prompt caching rugi kalau simpanan ditulis tetapi tidak pernah dibaca. Dari hasil di atas, satu request saja berarti Anda membayar 25 persen lebih mahal. Balik modal baru terjadi di request kedua, asalkan request itu datang sebelum masa simpan habis.
Dengan masa simpan 1 jam (tarif tulis 2 kali), hitungannya bergeser. Dua request masih rugi 5 persen, dan baru untung di request ketiga dengan hemat sekitar 27 persen. Jadi untuk fitur yang jarang dipakai, misalnya laporan yang dibuat sekali sehari, caching dengan tarif tulis tidak memberi manfaat.
Bagaimana aturan prompt caching di tiap penyedia model?
Aturan prompt caching berbeda di tiap penyedia: ada yang otomatis, ada yang perlu penanda, dan tarifnya tidak selalu sama. Tabel berikut merangkum dokumentasi resmi tiga penyedia besar per 15 November 2026. Angka bisa berubah, jadi cek lagi halaman resminya sebelum menghitung anggaran.
| Aspek | Anthropic (Claude) | OpenAI (GPT) | Google (Gemini) |
|---|---|---|---|
| Cara aktif | Tambahkan penanda cache_control, bisa otomatis dengan satu penanda di level atas | Aktif otomatis untuk model yang didukung | Implicit caching aktif otomatis untuk Gemini 2.5 dan yang lebih baru |
| Batas minimum awalan | 512 sampai 4.096 token, tergantung model | 1.024 token untuk model terbaru | 2.048 sampai 4.096 token, tergantung model |
| Tarif tulis | 1,25 kali (5 menit) atau 2 kali (1 jam) | 1,25 kali (30 menit) atau 2,5 kali (12 jam) pada model terbaru | Tidak disebut tarif tulis terpisah |
| Tarif baca | 0,1 kali, lebih rendah di beberapa model terbaru | 0,1 kali pada model terbaru, diskon disebut sampai 95 persen | Penghematan diteruskan otomatis saat cache kena, tanpa angka persen di halaman dokumentasi |
| Cara cek di respons | cache_creation_input_tokens dan cache_read_input_tokens | cached_tokens di dalam input_tokens_details | total_cached_tokens di data pemakaian |
Apa yang sering disalahpahami tentang prompt caching?
Kesalahpahaman paling umum adalah mengira prompt caching menyimpan jawaban. Berikut beberapa anggapan yang perlu diluruskan.
- "Cache berarti jawabannya diambil dari simpanan." Bukan. Yang disimpan adalah hasil olahan awalan prompt. Model tetap menulis jawaban baru setiap kali, dan dokumentasi resmi menyebut caching tidak mengubah hasil keluaran. Menyimpan jawaban adalah teknik lain, yaitu response caching, yang Anda buat sendiri di sisi aplikasi.
- "Cache itu memori jangka panjang AI." Bukan. Simpanan kedaluwarsa dalam hitungan menit sampai jam, dan tidak membuat model "mengingat" pelanggan Anda. Untuk membuat AI menjawab dari dokumen sendiri, tekniknya adalah RAG dan embedding.
- "Kalau ada cache, pasti hemat." Tidak selalu. Seperti hitungan di atas, simpanan yang ditulis tetapi tidak pernah dibaca justru menambah biaya.
- "Semua token jadi murah." Hanya awalan yang cocok. Pertanyaan baru tetap tarif input normal, dan token output tidak mendapat diskon cache sama sekali.
- "Prompt pendek juga ikut di-cache." Tidak. Di bawah batas minimum, request diproses biasa tanpa cache dan tanpa pesan error, jadi Anda bisa tidak sadar bahwa cache tidak pernah aktif.
- "Cache pasti membuat respons lebih cepat." Sering, tetapi tidak dijamin. Salah satu dokumentasi resmi menyebut cache read tidak menjamin latensi lebih rendah.
Kenapa cache sering meleset?
Cache paling sering meleset karena ada teks yang berubah-ubah di bagian depan prompt. Penyebab klasiknya adalah jam, tanggal, atau nama pelanggan yang disisipkan ke instruksi sistem.
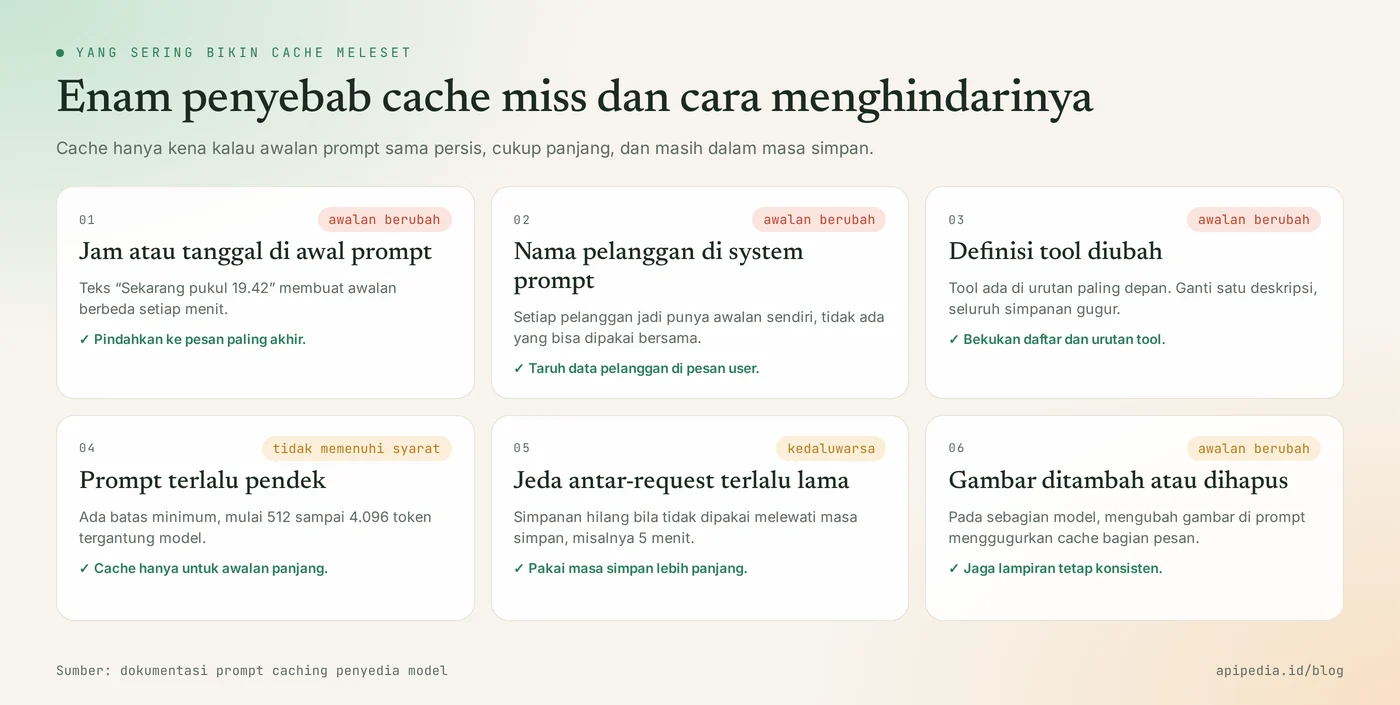
Perbandingan sederhananya seperti ini. Pada susunan pertama, awalan berubah setiap menit sehingga cache tidak pernah kena. Pada susunan kedua, bagian tetap ada di depan dan bagian yang berubah ada di belakang.
# Meleset terus: bagian yang berubah ada di depan
system : "Sekarang 15 Nov 2026 19.42. Pelanggan: Bu Rina. [SOP toko 4.000 token]"
user   : "Ongkir ke Malang berapa?"

# Kena cache: bagian tetap di depan, yang berubah di belakang
system : "[SOP toko 4.000 token]"
user   : "Waktu: 15 Nov 2026 19.42. Pelanggan: Bu Rina. Ongkir ke Malang berapa?"
Bagaimana cara memakai prompt caching dengan benar?
Cara memakai prompt caching dengan benar adalah menata prompt dari yang paling jarang berubah ke yang paling sering berubah, lalu memeriksa angka cache di respons. Langkah praktisnya:
- Urutkan dari yang paling stabil. Definisi tool, instruksi sistem, dokumen rujukan, baru kemudian riwayat chat dan pertanyaan terbaru.
- Keluarkan data yang berubah dari awalan. Jam, tanggal, nama pengguna, dan ID pesanan diletakkan di pesan terakhir.
- Bekukan definisi tool. Jangan mengacak urutan atau menyusun ulang deskripsi tool di setiap request.
- Cek batas minimum model Anda. Awalan 300 token tidak akan pernah di-cache di model mana pun pada tabel di atas.
- Pilih masa simpan sesuai pola trafik. Chat yang ramai cukup dengan masa simpan pendek. Untuk trafik yang datang tiap 10 sampai 30 menit, pertimbangkan masa simpan lebih panjang dan hitung ulang titik balik modalnya.
- Pantau angka cache di respons. Kalau angka token cache yang dibaca selalu nol, berarti ada yang berubah di awalan.
Contoh penanda cache pada request ke model Claude dengan SDK Python resmi, mengikuti format di dokumentasinya. Ganti nama model dengan model yang Anda pakai.
import anthropic

client = anthropic.Anthropic()
SOP_TOKO = open("sop_toko.txt").read()   # teks panjang yang sama untuk semua pelanggan

resp = client.messages.create(
    model="claude-haiku-5-5",
    max_tokens=300,
    system=[{
        "type": "text",
        "text": SOP_TOKO,
        "cache_control": {"type": "ephemeral"},   # batas cache: semua sampai blok ini disimpan
    }],
    messages=[{"role": "user", "content": "Ongkir ke Malang berapa?"}],
)

u = resp.usage
print("ditulis ke cache :", u.cache_creation_input_tokens)
print("dibaca dari cache:", u.cache_read_input_tokens)
print("input biasa      :", u.input_tokens)
Pada panggilan pertama, angka "ditulis ke cache" terisi. Pada panggilan kedua dalam masa simpan, angka itu pindah ke "dibaca dari cache". Kalau tidak pindah, periksa lagi enam penyebab di atas.
Bagaimana kalau memakai AI Gateway APIPedia?
Di AI Gateway APIPedia, Anda memanggil model dari berbagai penyedia lewat satu base URL dan satu token, memakai SDK resmi OpenAI atau Anthropic. Prinsip menata prompt di atas tetap sama: bagian tetap di depan, bagian berubah di belakang. Daftar model dan harganya ada di GET /models. Apakah sebuah model melaporkan dan memberi tarif cache bergantung pada model dan penyedianya, jadi periksa bagian usage pada respons untuk memastikan, jangan diasumsikan.
Pertanyaan yang sering diajukan
Apakah prompt caching mengubah jawaban AI?
Tidak. Dokumentasi resmi menyebut caching tidak berpengaruh pada pembuatan keluaran. Jawaban yang dihasilkan sama seperti tanpa cache, hanya bagian awalan tidak diproses ulang dari nol.
Apa bedanya prompt caching dengan RAG?
Prompt caching menghemat biaya membaca teks yang sama berulang kali. RAG memilih potongan dokumen yang relevan supaya teks yang dikirim lebih sedikit. Keduanya bisa dipakai bersamaan: instruksi tetap di-cache, potongan dokumen hasil pencarian ditaruh setelahnya.
Apakah data saya di cache bisa terbaca pengguna lain?
Cache dicocokkan berdasarkan isi awalan yang sama persis, dan penyedia model memisahkan simpanan antar-organisasi. Detail isolasinya berbeda per penyedia, jadi untuk data sensitif baca kebijakan penyimpanan data penyedia yang Anda pakai. Menjaga API key tetap rahasia masih menjadi pertahanan utama.
Apakah prompt caching perlu diaktifkan manual?
Tergantung penyedia. Sebagian mengaktifkannya otomatis untuk prompt yang cukup panjang, sebagian lain meminta penanda batas cache di request. Lihat tabel aturan tiap penyedia di atas.
Apakah cache membantu saat terkena rate limit?
Bisa membantu di sebagian penyedia, karena token yang dibaca dari cache dihitung berbeda dalam batas pemakaian. Aturannya tidak seragam, jadi jangan menjadikannya satu-satunya strategi. Dasar-dasarnya ada di artikel rate limit dan error 429.
Untuk melanjutkan belajar, baca juga cara kerja token dan tokenizer, cara kerja RAG dan embedding, serta apa itu MCP dan bedanya dengan API biasa. Definisi tool dari server MCP juga ikut masuk awalan prompt, jadi menjaganya tetap stabil membantu cache terpakai.
Sumber
Topik: #prompt caching #ai #explainer #llm #token #ai gateway
Tentang penulis
Tim APIPedia — Tim Engineering APIPedia
Tim engineering di balik APIPedia yang membangun dan memelihara API data Indonesia - ongkir, OCR KTP, data wilayah, BMKG, hingga server MCP - dan menulis panduan integrasinya dari pengalaman langsung.